Étude et démonstrateur
Grand contexte : tout lire d'un coup
L’aiguille dans la botte de foin, partie 2 sur 7. Un modèle local peut-il retrouver un fait modifié dans un roman de 235 000 tokens ?
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup ← vous êtes ici
- RAG : le bibliothécaire et son catalogue
- Recherche hybride : quand les mots exacts comptent
- Recherche agentique : laisser le modèle chercher
- RLM : le modèle qui écrit sa propre recherche
- Le verdict : quelle architecture, pour quelle botte de foin
L’idée la plus simple d’abord
Vous avez un long document et un petit fait caché quelque part dedans. L’architecture la plus évidente, c’est pas d’architecture du tout : donner tout le document au modèle et poser la question.
Pas d’index, pas de découpage, pas d’embeddings, pas de pipeline de recherche à régler. Si la fenêtre de contexte du modèle est assez grande, il voit tout.
Les modèles cloud aux fenêtres d’un million de tokens ont donné l’impression que le problème était réglé. Le test classique de « l’aiguille dans la botte de foin », où une phrase est cachée dans un long texte, frôle les 100 % pour les modèles de pointe.
Mais je voulais savoir ce qui se passe sur un matériel qu’une petite entreprise peut réellement posséder. Une machine de bureau, un modèle ouvert, pas de cloud. C’est la question de cette série, et le grand contexte est la référence à laquelle toutes les autres approches seront comparées.
Le dispositif
Matériel. Un ASUS Ascent GX10 : puce NVIDIA GB10, 128 Go de mémoire partagée entre CPU et GPU. Il est posé sur mon bureau.
Modèle. Qwen3.8-27B, quantifié en NVFP4, servi par vLLM 0.25.1. Les réglages qui comptent pour ce test :
- fenêtre de contexte de 262 144 tokens ;
- cache KV stocké en fp8 (la mémoire qui garde le document « lu », compressée) ;
- cache de préfixe activé, pour qu’un document lu une fois soit réutilisé à la question suivante ;
- mode raisonnement activé, avec le même budget de sortie (4 096 tokens) pour chaque question.
Botte de foin. Vingt mille lieues sous les mers de Jules Verne, en français. Deux tailles :
| Palier | Contenu | Taille |
|---|---|---|
| T1 | Premiers chapitres | 26 400 tokens |
| T2 | Le roman entier | 235 700 tokens |
T2 remplit 90 % de la fenêtre de contexte. C’est à peu près le maximum de ce dispositif. Les paliers plus grands de la série (7 et 33 romans) ne tiennent pas du tout.
Fabriquer des aiguilles impossibles à tricher
Voilà le problème d’un roman célèbre : le modèle l’a probablement lu. Demandez « qui commande la frégate lancée à la poursuite du monstre ? » et il risque de répondre « Farragut » de mémoire, sans lire un mot du texte fourni.
Je n’ai donc pas ajouté d’aiguilles au livre. J’ai modifié des faits qui s’y trouvent déjà, partout où ils apparaissent :
| Original (Verne) | Modifié | Position dans le livre |
|---|---|---|
| 1866 | 1858 | ~0 % |
| Farragut | Whitcombe | ~0 % |
| Scotia | Thessalia | ~1 % |
| Crespo | Moreira | 25 % |
| Vanikoro | Rotuma | 33 % |
| Manaar | Kalpitiya | 49 % |
| Arabian-Tunnel | Sinaï-Tunnel | 56 % |
| Vigo | Ferrol | 65 % |
| Atlantide | Thalassie | 68 % |
| Maelström | Corryvreckan | 99 % |
Seize modifications au total : six dans les premiers chapitres, dix réparties de 25 % à 99 % du livre.
Chaque modification est une petite règle d’expression régulière appliquée à tout le texte, pour que le livre reste cohérent : le Nautilus est entraîné dans le Corryvreckan chaque fois qu’il en est question, pas une seule fois.
Chaque réponse a ainsi trois sens possibles :
- contexte : le modèle donne le fait modifié (Whitcombe). Il a lu le texte. Juste.
- paramétrique : le modèle donne l’original de Verne (Farragut). Il a répondu de mémoire et ignoré le texte.
- mixte : les deux (« l’Atlantide, aussi appelée Thalassie »). Il a vu le texte mais n’a pas su lâcher ce qu’il savait.
Tout le reste, y compris « NOT FOUND », est un échec.
La référence : que sait déjà le modèle ?
Avant de lui donner le livre, j’ai posé chaque question sans aucun texte, en demandant au modèle de répondre de mémoire ou de dire qu’il ne sait pas.
Il connaît bien certains faits : l’Atlantide et le Maelström (3 sur 3), Farragut, le Scotia, Vanikoro, le golfe de Manaar (2 sur 3). Il en ignore d’autres : le nom de la frégate, la prime, l’île où Nemo part chasser.
C’est important. Quand le modèle répond « Corryvreckan » avec le livre sous les yeux, la référence prouve qu’il a surmonté quelque chose qu’il savait. Quand il répond « Moreira », cela prouve seulement qu’il a trouvé quelque chose de nouveau.
Sans le livre, il ne donne jamais de réponse modifiée : 0 juste sur 132 réponses sans contexte. Les modifications ne se devinent pas.
Les répétitions
Chaque question a été posée 6 fois, à la température 0,6, avec la même consigne et les mêmes réglages à chaque fois, sur les premiers chapitres et sur le roman entier.
Un seul passage par question ne suffit pas : le même dispositif peut rater un fait une fois et le trouver la suivante.
Résultats
Précision selon la position dans le livre
T2, le roman entier (l’Atlantide, à 68 %, est traitée plus bas) :
| Position dans le livre | Aiguilles | Justes |
|---|---|---|
| Début (0–3 %) | 6 | 36 / 36 · 100 % |
| Première moitié (25–35 %) | 3 | 18 / 18 · 100 % |
| Milieu (49–65 %) | 3 | 11 / 15 · 73 % |
| Fin (81–99 %) | 3 | 18 / 18 · 100 % |
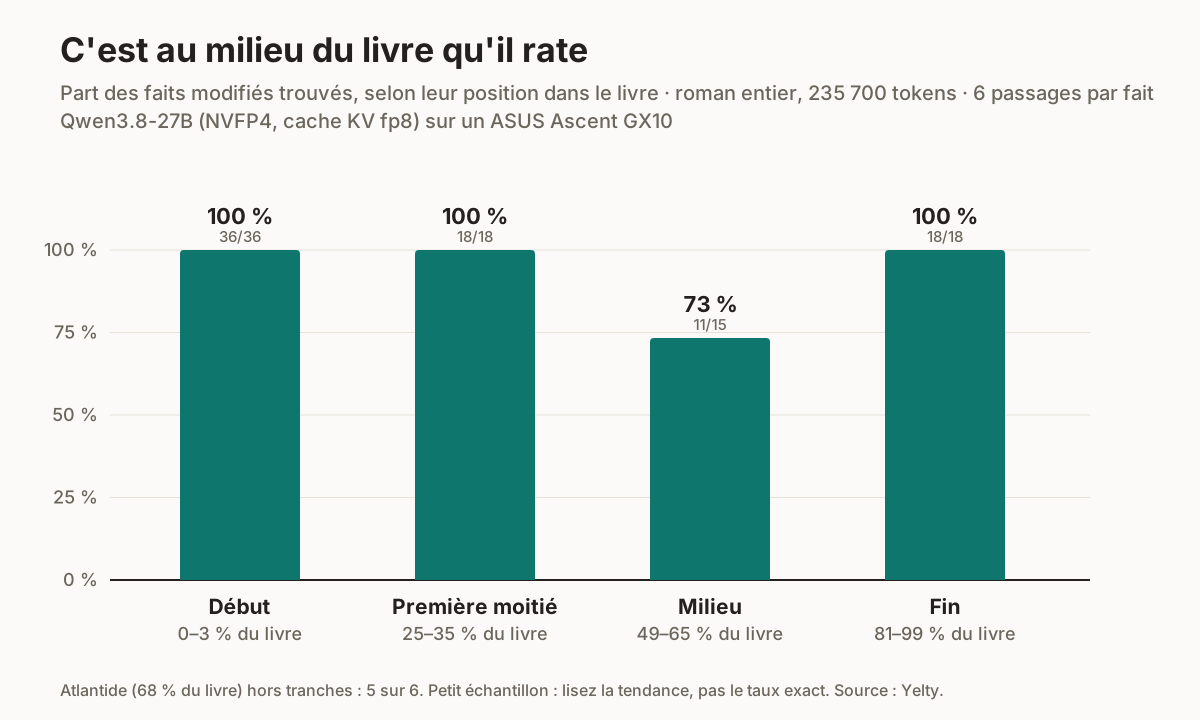 Le début, la première moitié et la fin sont parfaits. Le milieu est la seule zone où le modèle rate.
Le début et la fin sont parfaits. Les échecs sont au milieu.
C’est l’effet « lost in the middle » décrit par les chercheurs pour les longs contextes : les modèles accordent plus d’attention au début et à la fin d’un long texte qu’à ce qui se trouve entre les deux. On le retrouve ici sur un modèle quantifié, sur une seule machine, avec un vrai livre plutôt qu’un texte de remplissage synthétique.
Est-ce solide ? Chaque échec, sans exception, se situait entre 49 % et 68 % du livre : le golfe de Manaar deux fois, la baie de Vigo deux fois, et une Atlantide hésitante. Tout ce qui précède et suit est à 100 %.
Six passages par aiguille, c’est un petit échantillon : je n’avancerai donc pas de chiffre précis pour le milieu. Mais la tendance est nette.
Sur le petit palier (T1, 26 400 tokens), toutes les réponses étaient justes.
Quand il rate, il le dit
C’est le résultat que je n’attendais pas, et probablement le plus utile.
Presque chaque échec était un « NOT FOUND ». Le modèle n’a inventé ni île ni nom de navire : 4 des 5 échecs étaient des NOT FOUND ; le cinquième nommait les deux continents (« Thalassie, l’Atlantide de Platon »).
Pour un usage en entreprise, cela compte plus que le taux de réussite. Un système qui dit « je n’ai pas trouvé » peut être repéré, relancé ou renvoyé vers un humain. Un système qui invente une réponse avec aplomb, non.
Il fait confiance au texte plutôt qu’à sa mémoire
Les aiguilles contrefactuelles devaient attraper le modèle quand il répond de mémoire. Il ne l’a presque jamais fait.
Le Maelström est le cas le plus net. Sans le livre, le modèle répond « Maelström » à chaque fois. Avec le livre modifié, il répond « Corryvreckan » à chaque fois, alors qu’il connaît très bien l’original.
L’Atlantide est la seule hésitation : 5 réponses sur 6 donnaient Thalassie ; la sixième nommait les deux continents.
Le coût de tout lire
| T1 (26 400 tokens) | T2 (235 700 tokens) | |
|---|---|---|
| Première question (lecture complète) | ~21–26 s | ~374–382 s (plus de 6 minutes) |
| Vitesse de lecture | ~1 250 tokens/s | ~630 tokens/s |
| Questions suivantes, temps jusqu’au premier mot | 1,7 s | 5,3 s |
| Questions suivantes, réponse complète | médiane ~7 s | médiane ~15 s (10–40 s) |
Deux choses ressortent.
La lecture ralentit quand le document grandit. À 235 000 tokens, le modèle lit deux fois moins vite qu’à 26 000. L’attention compare chaque token à tous les autres, donc le coût croît plus vite que la longueur.
Le cache de préfixe change tout. La première question paie les six minutes. Chaque question suivante réutilise le livre déjà lu : 233 600 des 235 700 tokens venaient du cache (99,1 %). Six minutes une fois, puis environ 15 secondes par question.
Le grand contexte est donc viable quand on pose beaucoup de questions sur le même document. Il convient mal quand chaque question arrive avec un nouveau gros document : on repaie les six minutes à chaque fois.
Ce que je dirais à un client
Quand le grand contexte convient
- Le document tient largement dans la fenêtre (ici, jusqu’à ~235 000 tokens).
- Vous poserez beaucoup de questions sur le même document : la première lecture n’est payée qu’une fois.
- Il vous faut une première version rapidement : pas d’index, pas de pipeline, rien à régler.
- Une réponse « not found » est acceptable et peut être traitée.
Quand il ne convient pas
- Le corpus dépasse la fenêtre, ou ne cesse de grandir. À 236 000 tokens, ce dispositif était déjà à 90 % de sa limite.
- Chaque demande arrive avec un autre gros document : vous payez la lecture complète à chaque fois.
- Le fait critique peut se trouver au milieu du document, et un échec coûte cher. Parfait aux deux extrémités, nettement moins au milieu.
- La latence compte dès la première question. Six minutes, ce n’est pas interactif.
Le grand contexte est la bonne référence : simple, honnête, étonnamment précis. Mais il bute sur un plafond de taille, et sa fiabilité n’est pas uniforme d’un bout à l’autre du document.
Limites de ce test
Par honnêteté envers les résultats, et envers quiconque voudrait les reproduire :
- Un modèle, une quantification, un livre. Poids en NVFP4 et cache KV en fp8. Un cache KV plus précis réduirait peut-être la baisse au milieu ; cette comparaison reste à faire.
- Trois aiguilles dans la zone du milieu. Une aiguille difficile pèse lourd. Davantage d’aiguilles entre 40 % et 70 % rendraient la courbe plus solide.
- L’échantillon est petit : 6 réponses par aiguille. Assez pour voir où sont les échecs, pas assez pour un taux précis.
- Uniquement des modifications contrefactuelles. Pas encore de questions dont la réponse demande deux faits de chapitres différents, ni de questions qui ne partagent aucun mot avec le texte.
La suite : le RAG
Le grand contexte lit tout, à chaque fois. L’article suivant teste l’idée inverse : découper la bibliothèque en morceaux, les indexer, et ne montrer au modèle que les quelques morceaux qui semblent pertinents pour la question.
Cela passe bien au-delà de 235 000 tokens : jusqu’à 33 romans sur la même machine. Cela rate aussi des faits que le grand contexte trouve à chaque fois, et, curieusement, réussit les deux sur lesquels le grand contexte bute. → Partie 3 : le RAG