Étude et démonstrateur
RAG : le bibliothécaire et son catalogue
L’aiguille dans la botte de foin, partie 3 sur 7. Que se passe-t-il quand le modèle ne lit que les pages qu’un moteur de recherche lui tend ?
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup
- RAG : le bibliothécaire et son catalogue ← vous êtes ici
- Recherche hybride : quand les mots exacts comptent
- Recherche agentique : laisser le modèle chercher
- RLM : le modèle qui écrit sa propre recherche
- Le verdict : quelle architecture, pour quelle botte de foin
L’idée inverse
Dans la partie 2, le modèle lisait tout le roman pour chaque question. Cela marchait bien, mais se heurtait à deux murs : six minutes pour la première lecture, et un plafond strict autour de 236 000 tokens. Sept romans ne tiennent pas. Trente-trois, encore moins.
Le RAG (retrieval-augmented generation, génération augmentée par la recherche) prend le contre-pied. On ne montre jamais toute la bibliothèque au modèle. Un moteur de recherche choisit une poignée de passages qui semblent pertinents pour la question, et le modèle répond à partir de ceux-là seulement.
En termes de bibliothèque : un bibliothécaire avec un catalogue organisé par le sens. Vous posez votre question au comptoir, le bibliothécaire rapporte les pages les plus proches, et vous ne parcourez jamais les rayons vous-même.
C’est l’architecture la plus courante derrière les produits du type « discutez avec vos documents ». La question est ce qu’elle coûte en précision, et comment elle échoue.
Le fonctionnement ici
1. Découper le texte en extraits. Chaque palier est découpé en extraits d’environ 512 tokens (à peu près une page), coupés en fin de phrase, avec un chevauchement de 64 tokens pour qu’une phrase à la frontière figure dans les deux extraits voisins. Un extrait ne chevauche jamais deux chapitres.
2. Transformer chaque extrait en vecteur. Un petit modèle d’embeddings, Qwen3-Embedding-0.6B, transforme chaque extrait en une liste de 1 024 nombres qui représente son sens. Des extraits qui parlent de choses proches obtiennent des vecteurs proches.
3. Les stocker. Les vecteurs vont dans Qdrant, une base de données vectorielle, avec le texte de l’extrait, son chapitre et sa position dans le livre.
4. Au moment de la question, la question est elle aussi transformée en vecteur, et Qdrant renvoie les extraits les plus proches. Le modèle, le même Qwen3.8-27B que dans la partie 2, reçoit ces extraits et la question, rien d’autre.
Tout le reste est identique au test du grand contexte : même modèle, mêmes réglages, même consigne (« réponds uniquement à partir du texte, ou dis NOT FOUND »), mêmes 16 faits modifiés, même notation.
Un détail comptera plus loin : chaque extrait est présenté au modèle avec une courte étiquette donnant le titre de son chapitre, comme le font la plupart des systèmes RAG.
Combien d’extraits ? C’est le principal réglage de tout système RAG, qu’on appelle en général k. J’ai testé trois valeurs :
| k | Texte donné au modèle | Comparé au grand contexte sur un roman |
|---|---|---|
| 8 | ~4 000 tokens | 1,6 % du livre |
| 16 | ~7 500 tokens | 3,2 % |
| 32 | ~15 000 tokens | 6,4 % |
Les bottes de foin
Cette fois, les quatre paliers sont en jeu, puisque la taille de la bibliothèque n’importe pas au RAG :
| Palier | Contenu | Taille | Extraits |
|---|---|---|---|
| T1 | Premiers chapitres de Vingt mille lieues | 26 000 tokens | 66 |
| T2 | Le roman entier | 236 000 tokens | 599 |
| T3 | 7 romans | ~1,1 million de tokens | 2 852 |
| T4 | 33 romans | ~5 millions de tokens | 12 322 |
En T3 et T4, Vingt mille lieues est entouré d’autres romans de Verne. Quand un autre livre raconte la même histoire (L’Île mystérieuse raconte à nouveau la fin de Nemo), les modifications y sont aussi appliquées. Quand il s’agit d’une autre chose portant le même nom, elle reste telle que Verne l’a écrite. La partie 1 explique pourquoi.
Coût de préparation : l’index
Le grand contexte n’a aucune préparation. Le RAG doit d’abord construire son catalogue :
| Palier | Extraits | Tokens vectorisés | Durée |
|---|---|---|---|
| T1 (premiers chapitres) | 66 | 31 000 | 1,3 s |
| T2 (1 roman) | 599 | 281 000 | 30 s |
| T3 (7 romans) | 2 852 | 1,35 million | 50 s |
| T4 (33 romans) | 12 322 | 5,78 millions | 3 min 39 s |
Moins de quatre minutes pour 33 romans, sur la même machine de bureau. C’est moins que ce dont le grand contexte a besoin pour lire un seul roman une fois. Et c’est payé une seule fois : ensuite, chaque question coûte une recherche de quelques millisecondes et une réponse courte.
Résultats
Chaque point représente 16 questions × 6 passages (T1 : 6 questions), regroupés sur deux campagnes complètes.
| Précision | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Grand contexte | 100 % | 95 % | ❌ | ❌ |
| RAG, 8 extraits | 83 % | 73 % | 65 % | 60 % |
| RAG, 16 extraits | 100 % | 71 % | 65 % | 65 % |
| RAG, 32 extraits | 100 % | 85 % | 79 % | 71 % |
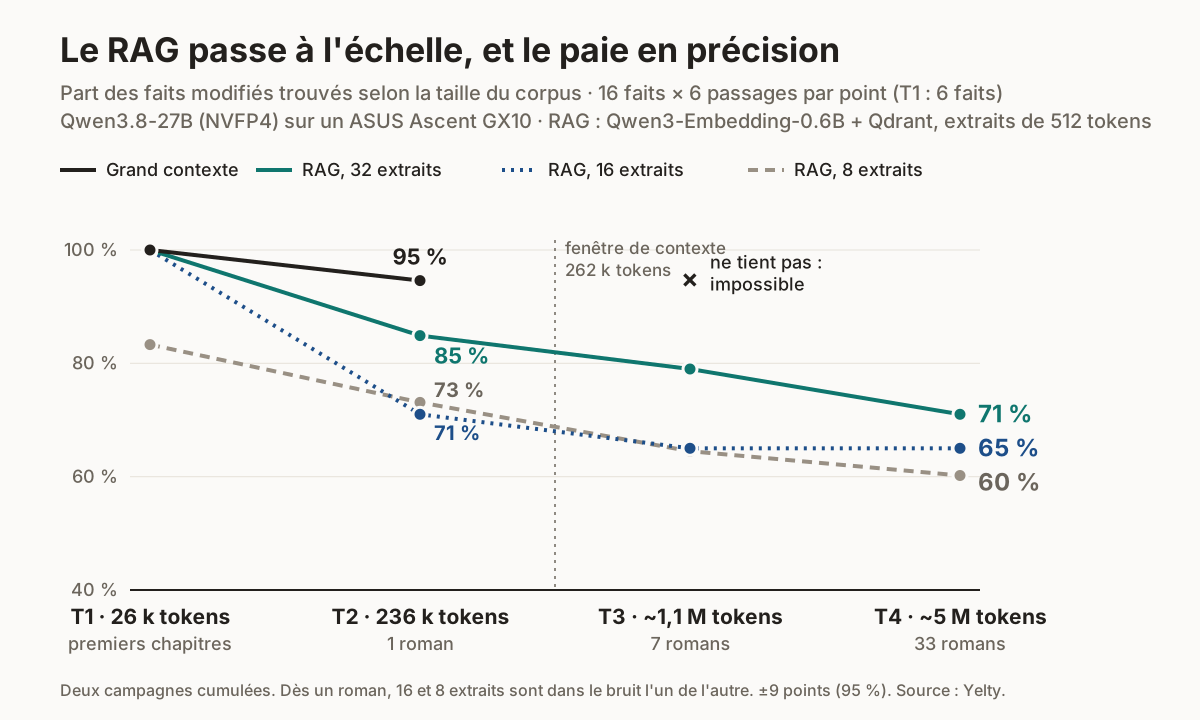 Le grand contexte s’arrête à la fenêtre de contexte. Le RAG continue, mais perd en précision à chaque livre ajouté.
Sur le bruit. Avec 93 réponses par point, chaque chiffre est précis à environ ±9 points. J’ai lancé tout le test deux fois, et sur des questions identiques la même configuration a obtenu 76 % une fois et 67 % l’autre. Seize extraits ne font donc pas vraiment moins bien que huit en T2 : l’écart reste dans le bruit. Les tendances ci-dessous se retrouvent dans les deux campagnes.
1. Le RAG passe à l’échelle ; la précision, non
La bonne nouvelle d’abord : le RAG tourne sur 33 romans sans forcer, et répond en 9 à 14 secondes environ (médiane) quelle que soit la taille de la bibliothèque. Pas de première question à six minutes. Le grand contexte ne peut même pas démarrer en T3.
Mais sur le seul roman que les deux savent traiter, le grand contexte gagne nettement : 95 % contre 85 % au mieux. Et à partir de là, chaque palier coûte de la précision au RAG : avec 32 extraits, 85 %, puis 79 %, puis 71 %.
2. Le RAG ne perd pas les faits du milieu. Il perd ceux qui sont formulés autrement
C’est le résultat le plus intéressant, parce que c’est l’exact inverse du grand contexte.
Pour chaque question, j’ai relevé le rang de l’extrait contenant la réponse dans les résultats de la recherche, parmi les 50 premiers :
| Fait | Position dans le roman | T1 | T2 | T3 | T4 |
|---|---|---|---|---|---|
| Commandant (Whitcombe) | ~0 % | 1 | 1 | 1 | 1 |
| Crespo → Moreira | 25 % | — | 1 | 1 | 1 |
| Manaar → Kalpitiya | 49 % | — | 2 | 2 | 2 |
| Vigo → Ferrol | 65 % | — | 10 | 10 | 10 |
| Première observation (Holloway) | ~0 % | 2 | 5 | 6 | 14 |
| Date (1858) | ~0 % | 10 | 14 | 19 | 24 |
| Prime | ~0 % | 1 | 3 | 24 | 48 |
| Atlantide → Thalassie | 68 % | — | hors des 50 | hors des 50 | hors des 50 |
| Date du pôle (25 mars) | 81 % | — | hors des 50 | hors des 50 | hors des 50 |
La position ne compte pas du tout. Le golfe de Manaar, au milieu du livre, est le fait sur lequel le grand contexte a le plus buté ; le RAG le trouve au rang 2 à chaque fois, à toutes les tailles. Les deux faits les plus durs pour le grand contexte, Manaar et Vigo, sont trouvés à chaque passage du RAG, sans exception.
Ce qui compte, c’est la formulation de la question et du passage. « Dans quel golfe Nemo emmène-t-il ses compagnons visiter les bancs de perles de Ceylan ? » tombe pile sur un passage qui parle de bancs de perles dans un golfe. Deux faits, l’Atlantide et la date à laquelle Nemo atteint le pôle Sud, n’ont jamais été retrouvés, à aucune taille, avec aucun nombre d’extraits, pas même dans le roman seul. Le moteur de recherche ne voit tout simplement pas le passage comme proche de la question. Aucun réglage de k n’y change rien. Le modèle a presque toujours répondu NOT FOUND ; quelques fois, il a décrit un continent englouti sans le nommer.
Et à mesure que la bibliothèque grandit, certaines réponses s’enfoncent. La prime et la date glissent dans le classement parce que les autres romans regorgent de primes et de dates : La Maison à vapeur mentionne à elle seule 1858 plusieurs fois, dans une tout autre histoire. Le bon passage est toujours là ; il n’est simplement plus parmi les plus proches.
3. Plus d’extraits aident la recherche et gênent la lecture
La solution évidente pour un fait au rang 24, c’est de donner plus d’extraits au modèle. Cela marche : la date, qui n’arrivait jamais dans la consigne avec 8 ou 16 extraits en T3 et T4, a été trouvée 6 fois sur 6 avec 32.
Mais plus d’extraits, c’est aussi plus de bruit à lire. Le navire de guerre français où le Nautilus fait halte (le Redoutable) est classé 4e à chaque fois, donc toujours dans la consigne. Avec 8 extraits, le modèle l’a trouvé 15 fois sur 18 de T2 à T4. Avec 32, seulement 11 fois sur 18 : le reste, des NOT FOUND, alors que la réponse était là, dans le texte.
k est donc un compromis, pas un curseur qu’on pousse au maximum. Trop peu d’extraits et la réponse n’y est pas ; trop et le modèle la rate au milieu des autres.
4. Quand la bibliothèque grandit, les réponses fausses apparaissent
Dans la partie 2, le résultat le plus rassurant était que le grand contexte n’invente presque jamais : sur le roman, 1 réponse sur 93 n’était ni juste ni « not found ».
Le RAG reste proche de cela sur le même roman : entre 0 et 4 réponses fausses sur 93 selon le nombre d’extraits. Sur 7 et 33 romans, cela change. Avec 16 extraits, 21 réponses sur 186 étaient fausses, et affirmées avec aplomb.
Le cas le plus net est le Maelström. Sur le roman seul, avec 32 extraits, le RAG a répondu « Corryvreckan » 6 fois sur 6. Avec 7 ou 33 romans, il a répondu « le Maelström » 5 fois sur 6 : le nom d’origine de Verne, que le texte ne contient plus nulle part dans Vingt mille lieues, alors que le bon extrait figurait dans la consigne.
Qu’est-ce qui a changé ? D’autres romans emploient le mot « maelström » au sens figuré : un tourbillon de rivière dans Le Village aérien, un tourbillon d’air dans L’Île mystérieuse. Ces extraits remontent pour une question sur un tourbillon, ils vont dans le sens de ce dont le modèle se souvient, et la mémoire l’emporte. Les leurres ne contiennent pas la réponse ; ils donnent au modèle la permission de se fier à lui-même.
La date montre la même chose : « 1859 » (une autre année du roman modifié), ou « 1866 » (l’année d’origine, toujours présente dans d’autres romans pour d’autres histoires). Toutes deux plausibles, toutes deux fausses, toutes deux affirmées avec assurance.
Pour un système d’entreprise, c’est le constat qui compte le plus. Un « not found » se gère. Une réponse fausse mais plausible part directement dans un rapport.
5. Une aide cachée : les titres de chapitre
Un résultat m’a intrigué. L’extrait de la baie de Vigo est classé 10e : avec 8 extraits, il n’est donc jamais dans la consigne. Pourtant le modèle a répondu « Ferrol » 18 fois sur 18.
La réponse était dans les étiquettes. Chaque extrait est présenté avec le titre de son chapitre, et le chapitre où Nemo récupère l’or des galions s’appelle « La baie de Ferrol » (dans mon texte modifié). N’importe quel extrait de ce chapitre porte la réponse dans son en-tête. La question du tunnel fonctionne de la même façon, grâce au titre de chapitre « Sinaï-Tunnel ».
Étiqueter les extraits avec le titre de leur section est une vraie technique, recommandée, et elle aide clairement. Mais cela signifie que pour ces deux faits, le test a mesuré les étiquettes plutôt que la recherche. Bon à savoir pour lire les chiffres, et bon à savoir pour concevoir un système : la structure de vos documents fait partie de votre recherche.
Coût et vitesse
| Grand contexte (1 roman) | RAG (tous paliers) | |
|---|---|---|
| Préparation | aucune | 30 s (1 roman) à 3 min 39 s (33 romans) |
| Première question | 6 min 20 s | ~10 s |
| Questions suivantes | ~15 s | 9–14 s (médiane) |
| Texte lu par question | 236 000 tokens | 4 000–15 000 tokens |
| Corpus maximal sur cette machine | ~236 000 tokens | testé jusqu’à 5 millions, aucune limite atteinte |
Ce que je dirais à un client
Quand le RAG convient
- Le corpus dépasse la fenêtre de contexte, ou ne cesse de grandir.
- Les questions emploient les mêmes mots et les mêmes idées que les documents (noms de produits, procédures, clauses).
- La latence compte dès la toute première question.
- Chaque question touche une petite partie du corpus.
Quand être prudent
- Les faits sont mentionnés en passant, dans un autre vocabulaire que la question. Certains ne seront jamais trouvés, quels que soient les réglages.
- Le corpus contient beaucoup de documents semblables (contrats, rapports, versions d’une même procédure). Les sosies font reculer le bon passage et rendent les réponses fausses plus probables.
- Une réponse fausse affirmée avec aplomb coûte cher. Mesurez combien de fois votre système en donne, pas seulement combien de fois il a raison.
- Ne réglez pas k à l’intuition. Plus d’extraits n’est pas toujours mieux. Testez-le sur vos propres questions.
Le RAG est ce qui rend les grands corpus possibles sur un matériel modeste. Ce n’est pas un substitut pur et simple à la lecture : sur un document qui tient dans le contexte, le grand contexte était nettement plus précis, et échouait plus honnêtement.
Limites de ce test
- Un modèle d’embeddings, un réglage. Qwen3-Embedding-0.6B, extraits de 512 tokens, pas de reranker, recherche par le sens uniquement. Des modèles d’embeddings plus gros ou d’autres tailles d’extraits pourraient faire bouger les chiffres.
- Le diagnostic de « rang » retient le premier extrait contenant la réponse modifiée. Pour une réponse présente à plusieurs endroits, cet extrait n’est pas toujours celui qui répond le mieux à la question.
- Les étiquettes de chapitre ont aidé deux faits (Vigo, le tunnel), comme expliqué plus haut.
- Six réponses par point. Assez pour les tendances, pas pour les petits écarts.
- Uniquement des faits contrefactuels, comme dans la partie 2.
La suite : la recherche hybride
Deux faits n’ont jamais été trouvés par le sens. Un troisième (la prime) sombre hors d’atteinte dans la bibliothèque complète. L’article suivant ajoute un index par mots exacts à côté de l’index par le sens, et une seconde passe qui reclasse les candidats.
Si le bon passage est invisible pour une recherche par le sens, une recherche par les mots peut-elle le trouver ? C’est la partie 4.