Étude et démonstrateur
Recherche hybride : quand les mots exacts comptent
L’aiguille dans la botte de foin, partie 4 sur 7. Ce qu’une formule de recherche par mots-clés vieille de trente ans a trouvé là où la recherche par le sens échouait.
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup
- RAG : le bibliothécaire et son catalogue
- Recherche hybride : quand les mots exacts comptent ← vous êtes ici
- Recherche agentique : laisser le modèle chercher
- RLM : le modèle qui écrit sa propre recherche
- Le verdict : quelle architecture, pour quelle botte de foin
Là où le RAG nous a laissés
Dans la partie 3, le RAG a rendu 33 romans interrogeables sur une seule machine de bureau. Mais deux faits n’ont jamais été trouvés, à aucune taille, avec aucun nombre d’extraits : le nom du continent englouti (l’Atlantide, rebaptisée Thalassie dans mon texte modifié) et la date à laquelle Nemo prend possession du pôle Sud (le 25 mars dans mon texte). Deux autres ont sombré hors d’atteinte quand la bibliothèque a grandi : la prime promise à qui repérera le « monstre » est passée du rang 3 au rang 48, et la date de l’affaire du rang 14 au rang 24.
Le moteur de recherche de la partie 3 ne travaillait que par le sens. Il transforme la question et chaque extrait en vecteurs et renvoie les plus proches. Cela marche quand la question et le passage parlent de la même chose de la même façon. Cela échoue sinon.
Les moteurs de recherche ont résolu une version de ce problème bien avant les modèles de langage. La recherche par mots-clés, avec une formule de score appelée BM25, classe les documents selon les mots qu’ils partagent avec la requête depuis les années 1990. Elle ne sait rien du sens. Elle compte les mots, et donne plus de poids aux mots rares.
La recherche hybride fait tourner les deux et fusionne les résultats. C’est toute l’idée de cet article.
Le fonctionnement ici
En termes de bibliothèque, encore : le même bibliothécaire que dans la partie 3, avec son catalogue par le sens, dispose désormais aussi d’un index de tous les mots de la bibliothèque. Un second lecteur vérifie ensuite les meilleures pages avant de les remettre.
1. Les mêmes extraits que le RAG. J’ai réutilisé tels quels les extraits de 512 tokens et leurs vecteurs de sens de la partie 3. Toute différence dans les résultats vient de ce qui a été ajouté, pas d’un autre découpage du texte.
2. Un index par mots-clés. Chaque extrait reçoit aussi un vecteur BM25 : ses mots, en minuscules, sans les mots courants du français (le, de, quel…), et réduits à leur racine. Les mots rares pèsent plus que les mots courants.
3. Deux recherches, une liste. Pour chaque question, la recherche par le sens et la recherche par mots-clés renvoient chacune leurs 50 meilleurs extraits. Les deux listes sont fusionnées par Reciprocal Rank Fusion : un extrait bien classé dans l’une ou l’autre liste se retrouve bien classé dans la liste fusionnée. Qdrant fait cela en une seule requête.
4. Un reranker. Les 50 extraits fusionnés passent par un petit modèle, Qwen3-Reranker-0.6B, qui lit la question et chaque extrait ensemble et évalue la probabilité que l’extrait y réponde. C’est plus lent que de comparer des vecteurs, mais bien plus précis, parce qu’il lit les deux textes côte à côte au lieu de comparer deux résumés. Les k meilleurs extraits vont au modèle qui répond.
J’ai aussi lancé une version sans reranker (étapes 1 à 3 seulement, 8 extraits), pour voir ce qu’apporte chaque pièce.
Coût de préparation
L’index par mots-clés est presque gratuit. Sur le roman seul, il a pris 2,5 secondes (599 extraits, 7 685 racines de mots distinctes), contre 30 secondes pour l’index par le sens. Il tourne sur le processeur ; aucun modèle n’intervient.
Le reranker est un modèle de plus à faire tourner : 0,6 milliard de paramètres, servi par sa propre petite instance vLLM à côté du modèle qui répond, avec 6 % de la mémoire de la machine. Il a mis trois minutes et demie à démarrer la première fois, puis il est resté en service.
Résultats
| Précision | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Grand contexte | 100 % | 95 % | ❌ | ❌ |
| RAG, 32 extraits (meilleur RAG) | 100 % | 85 % | 79 % | 71 % |
| Hybride, 8 extraits | 97 % | 93 % | 76 % | 76 % |
| Hybride, 16 extraits | 100 % | 94 % | 88 % | 83 % |
| Hybride, 32 extraits | 100 % | 94 % | 88 % | 84 % |
| Hybride, 8 extraits, sans reranker | 100 % | 83 % | 80 % | 76 % |
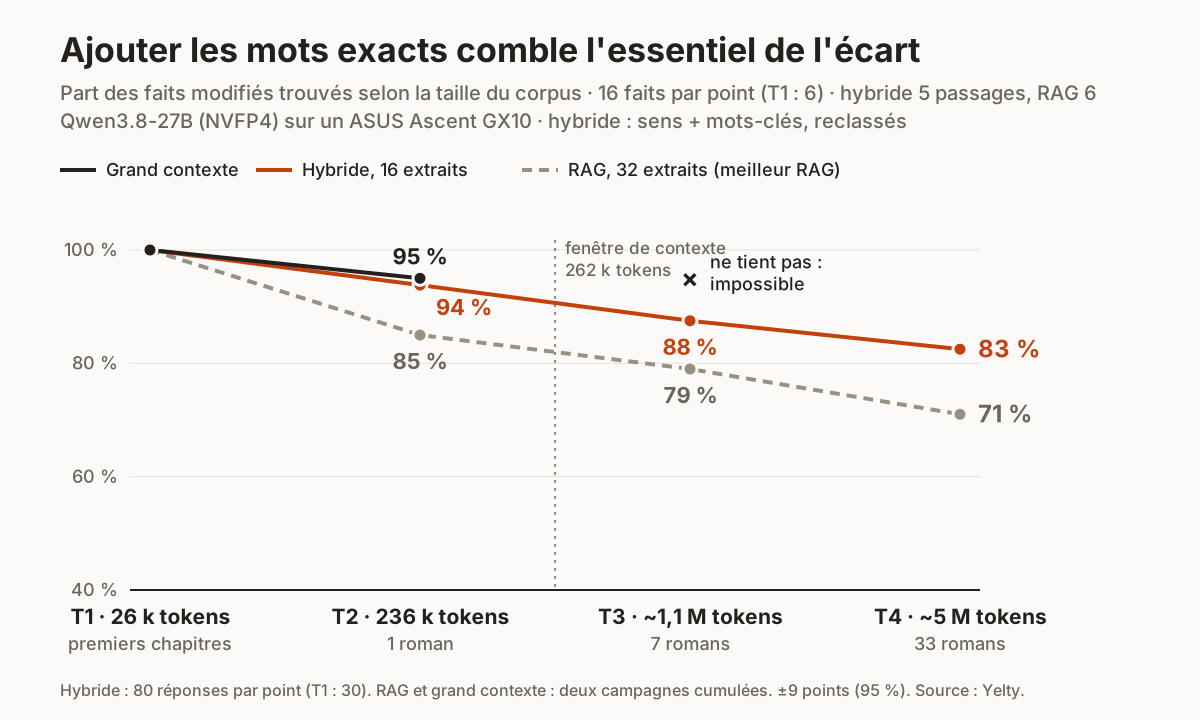 La recherche hybride suit le grand contexte sur un roman, puis continue. L’écart avec le RAG se creuse à mesure que la bibliothèque grandit.
Chaque chiffre de la recherche hybride repose sur 80 réponses (T1 : 30), soit environ ±9 points. Lisez les tendances, pas les décimales.
1. La recherche hybride égale le grand contexte, et va plus loin
Sur le roman seul, la recherche hybride à 16 extraits obtient 94 %, contre 95 % pour le grand contexte qui lit tout le livre. C’est le même résultat, aux erreurs de mesure près, avec environ 7 500 tokens de texte par question au lieu de 236 000, et sans première question à six minutes.
Sur 7 et 33 romans, là où le grand contexte ne peut pas tourner, elle tient à 88 % et 83 %. Le meilleur RAG était à 79 % et 71 %, et il lui fallait 32 extraits pour y arriver.
2. Les mots-clés ont trouvé ce que le sens ratait
Pour chaque question, j’ai relevé le rang de l’extrait contenant la réponse dans chaque recherche : par le sens, par mots-clés, et après le reranker.
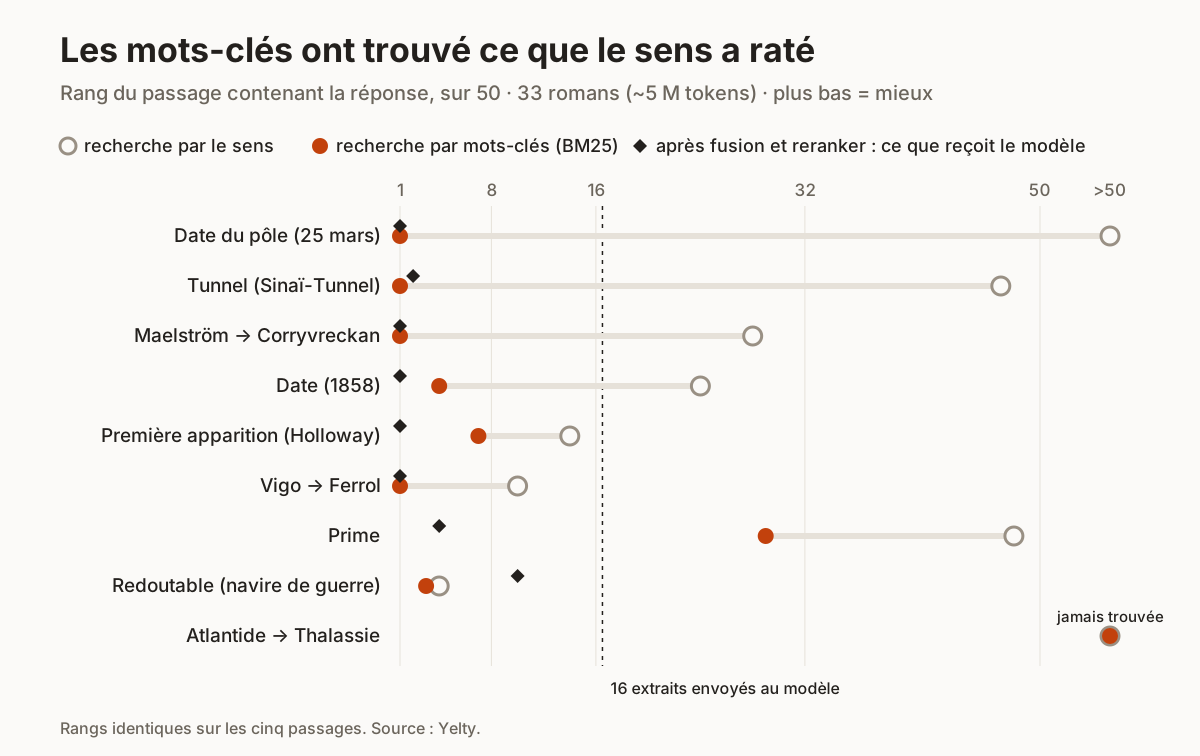 33 romans. Cercle gris : recherche par le sens (celle du RAG). Point orange : recherche par mots-clés. Losange : l’ordre final que voit le modèle.
| Fait | Sens (RAG) | Mots-clés | Après reranker |
|---|---|---|---|
| Date du pôle (25 mars) | hors des 50 | 1 | 1 |
| Tunnel (Sinaï-Tunnel) | 47 | 1 | 2 |
| Maelström → Corryvreckan | 28 | 1 | 1 |
| Date (1858) | 24 | 4 | 1 |
| Première observation (Holloway) | 14 | 7 | 1 |
| Vigo → Ferrol | 10 | 1 | 1 |
| Prime | 48 | 29 | 4 |
| Redoutable (navire de guerre) | 4 | 3 | 10 |
| Atlantide → Thalassie | hors des 50 | hors des 50 | — |
La date du pôle est le cas le plus net. La question demande : « À quelle date le capitaine Nemo prend-il possession du pôle Sud ? » Le passage dit : « moi, capitaine Nemo, ce 25 mars 1860, j’ai atteint le pôle sud […] et je prends possession de cette partie du globe ». Par le sens, le moteur de recherche ne les a jamais jugés proches, à aucun palier. Par les mots, possession et pôle sont assez rares pour placer le passage en tête, à chaque fois, à chaque palier. Avec le reranker, la réponse a été juste 45 fois sur 45.
Les rangs sont identiques sur les cinq passages, ce qui est normal : la recherche est déterministe. Toute la variation vient du modèle qui répond.
Sur l’ensemble du test, la recherche par le sens n’a jamais trouvé un passage que la recherche par mots-clés aurait raté. Chaque extrait qu’elle a trouvé, les mots-clés l’ont trouvé aussi. L’inverse n’est pas vrai. C’est propre à ce test : mes questions sont écrites dans le vocabulaire du roman, ce qui favorise les mots-clés. Sur des questions formulées avec d’autres mots que les documents, la recherche par le sens se rendrait utile. La recherche hybride garde les deux, pour ne pas avoir à le savoir à l’avance.
Avec 16 extraits, le passage contenant la réponse est arrivé jusqu’au modèle pour 15 des 16 faits, à chaque palier d’un roman à 33. Seule l’Atlantide manquait.
3. Le reranker aide, et parfois nuit
Comparez les deux versions à 8 extraits. Sur un roman, le reranker vaut 10 points (93 % contre 83 %). Sur 7 et 33 romans, l’écart reste dans le bruit (76 % contre 80 %, puis 76 % contre 76 %). La moyenne cache deux effets opposés.
Il sauve des faits que la liste fusionnée enterre. Sans reranker, sur 33 romans, le passage de la prime était 46e dans la liste fusionnée et la première observation 9e : jamais dans la consigne avec 8 extraits. Le reranker les a remontés au 4e et au 1er rang. La première observation est passée de 0 réponse juste sur 5 à 5 sur 5.
Il en fait aussi reculer. Le navire de guerre français où le Nautilus fait halte (le Redoutable) était 5e dans la liste fusionnée. Le reranker l’a descendu au 10e rang. Avec 8 extraits sur 7 et 33 romans, cela donnait 10 justes sur 10 sans reranker et 0 sur 10 avec, uniquement des NOT FOUND. Avec 16 extraits, de nouveau 10 sur 10.
Le reranker ne dispense donc pas de bien choisir k. Il change les faits qui se trouvent à la limite.
4. Les échecs restants sont des échecs de lecture
Trouver le passage n’est plus le problème principal. Ce qui reste se passe une fois le passage arrivé jusqu’au modèle.
La prime. Sur 7 et 33 romans, le passage est classé entre le 2e et le 4e rang, bien à l’intérieur de la consigne. Le modèle a pourtant répondu NOT FOUND 16 fois sur 30. Sur le roman seul, au même rang 2, il avait raison 15 fois sur 15. La différence, c’est l’entourage : les autres romans apportent d’autres primes et d’autres récompenses dans la consigne. Mon hypothèse : le modèle, à qui l’on demande de ne répondre que s’il est sûr, a préféré se taire. C’est une hypothèse ; le test ne la prouve pas.
Le Maelström. Sur 7 et 33 romans, le bon passage est classé 1er. Dans la partie 3, le RAG répondait « le Maelström » (le nom d’origine de Verne, qui n’apparaît plus dans mon roman modifié) 5 fois sur 6. La recherche hybride se comporte autrement : au moins 18 réponses sur 30 donnaient les deux noms, « Le Corryvreckan (Maëlstrom) », et une seule donnait le nom d’origine seul. Le modèle voit désormais clairement le texte modifié, mais d’autres romans emploient « maelström » pour n’importe quel tourbillon, et le modèle hésite. Ma notation compte une réponse à deux noms comme fausse, comme dans les parties précédentes. Curieusement, il faisait mieux sans reranker (6 justes sur 10), peut-être parce que le reranker remonte aussi les passages de tourbillons des autres romans. Là encore, une hypothèse.
L’Atlantide. Jamais trouvée, dans aucune configuration : 0 juste sur 60. Sur le roman seul, la recherche par mots-clés classait un passage nommant Thalassie 31e, trop bas pour survivre à la fusion ; sur 7 et 33 romans, aucune des deux recherches ne l’avait dans ses 50 premiers. La question (« Quel continent disparu le professeur Aronnax découvre-t-il au fond de l’océan ? ») ne partage presque aucun mot rare avec les passages qui nomment Thalassie, remplis de noms d’auteurs antiques (Platon, Théopompe, Origène). Le passage qui correspond vraiment à la question, « ce continent immense qui sans doute reliait l’Afrique à l’Amérique », vient quelques paragraphes après le nom, dans un autre extrait. Le modèle a donc répondu plusieurs fois par la description, sans le nom. La réponse était à un extrait près.
Ce dernier cas est une limite connue du découpage d’un livre en extraits : la question correspond à un extrait, la réponse se trouve dans son voisin. Une solution courante consiste à ajouter les voisins de chaque extrait à la consigne.
5. Réponses fausses : à peu près autant, mais d’une autre nature
Avec 16 extraits sur 7 et 33 romans, la recherche hybride a donné 19 réponses fausses sur 160 (12 %). Le RAG en donnait 21 sur 186 (11 %). Le même taux.
Mais chacune de ces 19 venait de deux faits : le Maelström (les deux noms) et l’Atlantide (une description sans nom). Aucun autre fait n’a reçu de réponse fausse, avec 8, 16 ou 32 extraits. Les erreurs du RAG étaient réparties sur plusieurs faits, et comprenaient de franches valeurs fausses : « 1859 » ou « 1866 » pour la date. Avec la recherche hybride, le passage de la date est au rang 1, et sur 7 et 33 romans la date était juste à chaque fois. (Sur les petits paliers, avec 8 extraits, le modèle a encore répondu « 1866 » de mémoire deux fois sur 10.)
Pour un système d’entreprise, c’est un meilleur type d’échec. Une réponse hésitante qui cite les deux options peut être repérée par un humain. Une année fausse affirmée avec aplomb, non.
Coût et vitesse
| Grand contexte (1 roman) | RAG | Recherche hybride | |
|---|---|---|---|
| Préparation | aucune | 30 s (1 roman) à 3 min 39 s (33 romans) | index du RAG + 2,5 s (1 roman) pour les mots-clés |
| Modèle supplémentaire en service | aucun | modèle d’embeddings | modèle d’embeddings + reranker |
| Première question | 6 min 20 s | ~10 s | ~10 s |
| Temps de réponse médian | ~15 s | 9–14 s | 8–11 s |
| Texte lu par question | 236 000 tokens | 4 000–15 000 tokens | 4 000–15 000 tokens |
| Texte écrit par réponse (médiane, raisonnement compris) | ~170 tokens | ~190–230 tokens | ~165–185 tokens |
| Précision, 1 roman / 33 romans | 95 % / ❌ | 85 % / 71 % | 94 % / 84 % |
Le reranker lit 50 extraits par question, et pourtant les temps de réponse médians restent à moins d’une seconde de la version sans reranker. Sur cette machine, il est presque gratuit.
Ce que je dirais à un client
Commencez par l’hybride, pas par le RAG seul
- La recherche par mots-clés coûte peu à ajouter : quelques secondes d’indexation, aucun modèle. La plupart des bases vectorielles la proposent nativement (Qdrant, OpenSearch, Elasticsearch, Postgres avec extensions).
- Les documents d’entreprise regorgent de mots exacts qui comptent : codes produits, noms de clients, numéros de clauses, dates, codes d’erreur. C’est là que la recherche par le sens est la plus faible et les mots-clés les plus forts.
- Ajoutez un reranker, et testez le nombre d’extraits sur vos propres questions. Le reranker règle la plupart des problèmes de classement, mais il peut aussi pousser un bon passage juste au-delà de la limite.
Ce qu’elle ne réglera pas
- Les questions qui ne partagent ni mots ni sens avec le passage. Il faut alors une autre approche : reformuler la question, ajouter les extraits voisins, ou laisser le modèle chercher lui-même (partie 5).
- Les documents sosies. Quand beaucoup de documents parlent de choses proches, le bon passage peut être dans la consigne et le modèle hésiter quand même. Mesurez combien de fois votre système répond « not found » avec la réponse sous les yeux.
Limites de ce test
- Des questions dans le vocabulaire du roman. Mes questions sont écrites en français, au plus près des mots de Verne. Cela favorise la recherche par mots-clés. Des questions écrites par des utilisateurs qui ne connaissent pas les documents favoriseraient davantage la recherche par le sens.
- Un reranker, des réglages par défaut. Qwen3-Reranker-0.6B, paramètres BM25 standard, 50 candidats par recherche. Des rerankers plus gros ou des paramètres ajustés pourraient faire bouger les chiffres.
- Cinq réponses par point. Environ ±9 points. La comparaison sans reranker en T3–T4 reste dans le bruit.
- Le diagnostic de « rang » retient le premier extrait contenant la réponse modifiée, comme dans la partie 3.
- Les étiquettes de chapitre sont toujours affichées avec chaque extrait. Elles comptaient pour deux faits dans la partie 3 (Vigo, le tunnel) ; ici, la recherche par mots-clés trouve de toute façon les deux passages au rang 1 ou 2.
- Uniquement des faits contrefactuels, comme dans les parties précédentes.
La suite : la recherche agentique
La recherche hybride a réglé le problème de recherche pour 15 faits sur 16. Le dernier, l’Atlantide, se trouve à un extrait du passage que la recherche trouve. Et la prime montre que même avec le bon passage au rang 2, le modèle peut abandonner.
Ce sont deux problèmes qu’un lecteur humain réglerait en regardant autour : lire la page précédente, chercher un autre mot, vérifier un second chapitre. Dans la partie 5, le modèle reçoit cette capacité. Plus de pipeline figé : il cherche, lit et décide lui-même quand il tient la réponse.