Étude et démonstrateur
Le verdict : quelle architecture, pour quelle botte de foin
L’aiguille dans la botte de foin, partie 7 sur 7. Six façons de trouver une phrase dans 33 romans, sur une seule machine, comparées.
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup
- RAG : le bibliothécaire et son catalogue
- Recherche hybride : quand les mots exacts comptent
- Recherche agentique : laisser le modèle chercher
- RLM : le modèle qui écrit sa propre recherche
- Le verdict : quelle architecture, pour quelle botte de foin ← vous êtes ici
La question de départ
La partie 1 posait une question simple : si vos documents ne peuvent pas quitter vos murs, que pouvez-vous faire avec du matériel qui vous appartient ?
Pendant deux semaines, une machine de bureau (un ASUS Ascent GX10) a fait passer à un modèle (Qwen3.8-27B) le même test : 16 faits que j’ai discrètement modifiés dans les romans de Jules Verne, posés 5 ou 6 fois chacun, sur une bibliothèque allant de quelques chapitres à 33 romans et environ 5 millions de tokens. Cinq architectures, six systèmes (l’agent en deux versions), même modèle, même consigne, même notation.
Cette partie les met côte à côte, et dit laquelle j’utiliserais pour quelle botte de foin.
Le tableau des scores
| Précision | T1 · chapitres | T2 · 1 roman | T3 · 7 romans | T4 · 33 romans |
|---|---|---|---|---|
| Grand contexte | 100 % | 95 % | ❌ | ❌ |
| RAG, 32 extraits | 100 % | 85 % | 79 % | 71 % |
| Hybride, 16 extraits | 100 % | 94 % | 88 % | 83 % |
| Agent, grep + lecture | 97 % | 91 % | 90 % | 88 % |
| Agent + recherche | 100 % | 95 % | 84 % | 88 % |
| RLM | 100 % | 94 % | 89 % | 91 % |
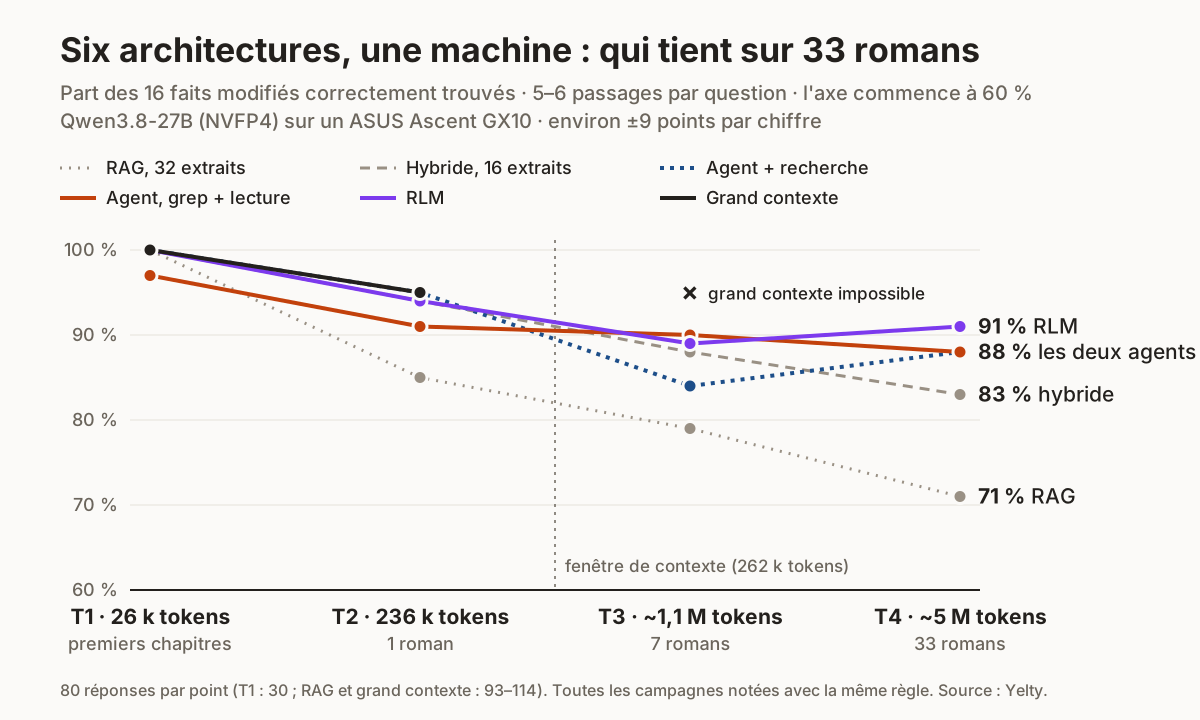 Sur un roman, tout sauf le RAG simple se situe entre 91 et 95 %. Sur 33 romans, les systèmes qui cherchent par eux-mêmes tiennent le mieux.
Chaque chiffre repose sur 80 à 114 réponses (T1 : 30), soit environ ±9 points. Lisez des groupes, pas des décimales :
- Sur un roman, le grand contexte, la recherche hybride, les deux agents et le RLM sont à égalité. Le RAG simple est derrière.
- Sur 33 romans, le grand contexte ne peut pas tourner, les agents et le RLM sont à égalité en tête (88–91 %), la recherche hybride est quelques points derrière (83 %), et le RAG simple est nettement dernier (71 %).
Vitesse et coût
| Grand contexte | RAG | Hybride | Agent, grep + lecture | Agent + recherche | RLM | |
|---|---|---|---|---|---|---|
| Préparation | aucune | index : 30 s à 3 min 39 s | index du RAG + mots-clés (secondes) | aucune | index de l’hybride | aucune |
| En service en plus | rien | modèle d’embeddings | modèle d’embeddings + reranker | rien | modèle d’embeddings + reranker | conteneur bac à sable |
| Plus grande bibliothèque | 1 roman | 33 romans | 33 romans | 33 romans | 33 romans | 33 romans |
| Réponse médiane, 33 romans | — | 12 s | 9 s | 26 s | 11 s | 44 s |
| 10 % les plus lents, 33 romans | — | 32 s | 35 s | 2 min 35 s | 40 s | 1 min 36 s |
| Tokens lus par question (médiane) | 236 000 (1 roman) | 15 300 | 7 700 | 10 600 | 5 600 | 11 000 |
| Tokens écrits par question (médiane) | 170 (1 roman) | 210 | 180 | 480 | 190 | 840 |
| Précision, 33 romans | — | 71 % | 83 % | 88 % | 88 % | 91 % |
Les tokens sont mesurés sur 33 romans sauf mention contraire ; pour les agents et le RLM, ils additionnent tous les appels au modèle de la question, raisonnement compris.
Le grand contexte sur un roman : 6 min 20 s pour la première question (lecture de 236 000 tokens), puis environ 15 s par question tant que le roman reste dans le cache du modèle.
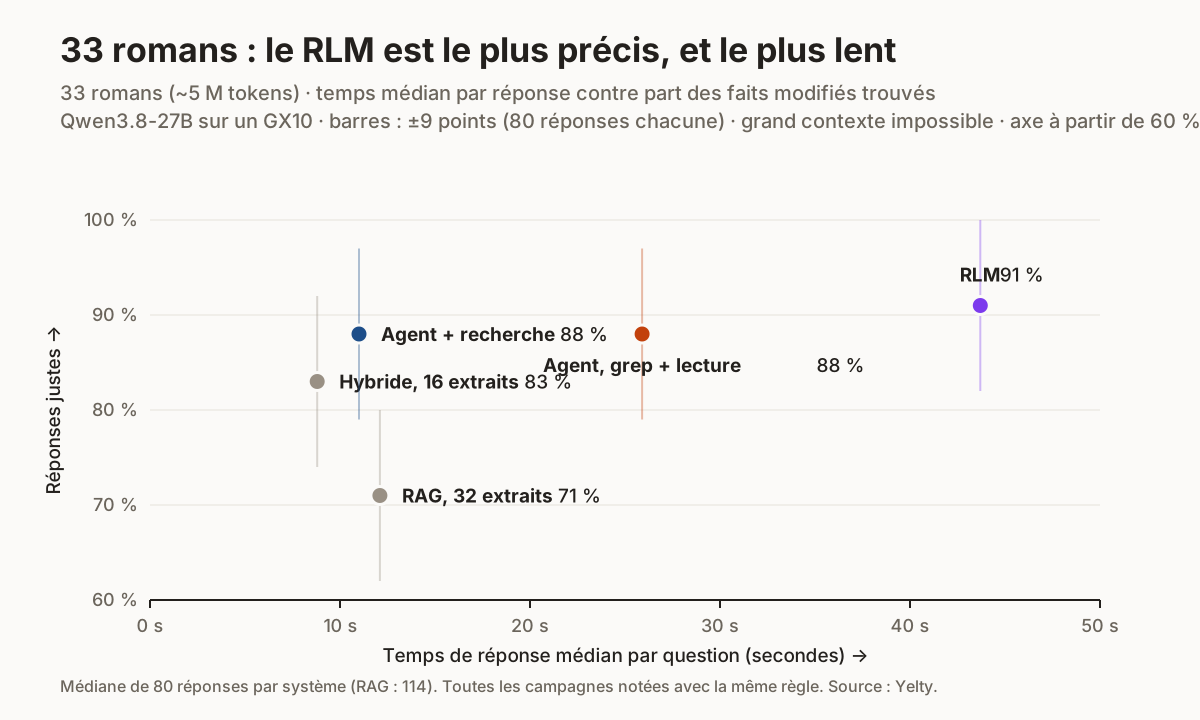 La précision coûte des secondes. L’agent avec recherche est le meilleur compromis : la vitesse de la recherche hybride, la précision d’un agent.
Comment chacun échoue
Le chiffre de précision dit à quelle fréquence. Pour un système métier, le comment compte tout autant.
| Échec typique | À quoi il ressemble | |
|---|---|---|
| Grand contexte | Les faits au milieu du livre | « NOT FOUND » : 4 de ses 5 ratés sur le roman non modifié |
| RAG | Des faits formulés autrement que la question ; des leurres venus d’autres livres | Des réponses fausses et assurées à mesure que la bibliothèque grandit : « le Maelström », « 1866 » |
| Hybride | Bon passage, mauvaise lecture | NOT FOUND avec la réponse dans la consigne (la prime) ; les deux noms (le Maelström) |
| Agents | L’a trouvé, puis a ajouté sa mémoire | « La Thalassie (l’Atlantide de Platon) » ; une réflexion qui s’épuise ; la question perdue |
| RLM | Saute la recherche, ou en écrit une boguée | Répond de mémoire au premier tour (6 fois sur 160 sur les grandes bibliothèques) ; une date voisine dans le bon chapitre |
Deux tendances traversent toutes les parties.
Plus la recherche est bonne, plus on voit la mémoire du modèle. Suivez l’Atlantide, rebaptisée Thalassie dans mon texte. Le RAG et la recherche hybride n’ont jamais trouvé le passage : 0 juste. Les agents l’ont trouvé à chaque fois et ont surtout répondu « Thalassie (l’Atlantide) », en ajoutant le nom appris à l’entraînement. Le RLM l’a trouvé et a répondu simplement « Thalassie » 9 fois sur 15. Une fois que la recherche fonctionne, les erreurs restantes viennent du modèle, pas de la recherche.
Les erreurs sont devenues plus sages à mesure que les architectures progressaient. Les mauvaises réponses du RAG étaient des valeurs plausibles : une mauvaise année, le nom d’origine. À partir de la recherche hybride, la plupart des erreurs étaient des hésitations (les deux noms), des NOT FOUND ou des absences de réponse. Les exceptions étaient rares : quelques réponses du RLM données de mémoire avant toute recherche, et une date lue dans le bon chapitre mais le mauvais paragraphe. Un humain repère une hésitation. Une année fausse donnée avec assurance part directement dans un rapport.
Quelle architecture, pour quelle botte de foin
Un document qui tient en mémoire (un contrat, un manuel, un rapport : jusqu’à un roman, environ 236 000 tokens, sur cette machine) → Le grand contexte. Pas d’index, pas de pipeline, 95 % sur un roman. Payez quelques minutes pour la première lecture, puis gardez-le en cache pour les questions suivantes.
Un grand corpus stable, beaucoup d’utilisateurs, des réponses en quelques secondes → La recherche hybride (sens + mots-clés + reranker). Jamais le RAG simple : les noms exacts, les codes et les dates sont là où la recherche par le sens seul échoue, et les documents d’entreprise en sont pleins. 83 % sur 33 romans en 9 secondes.
Un grand corpus où la précision compte plus que les secondes, ou qui change tous les jours → Un agent avec grep et lecture. Pas d’index à construire ni à synchroniser : un document est interrogeable dès qu’il est sur le disque. 88 % sur 33 romans, environ 26 secondes par question. Ajoutez la recherche hybride comme outil si vous avez l’index : même précision, 11 secondes.
Des questions qui demandent de calculer, pas de trouver (compter, comparer, extraire depuis des milliers d’endroits) → Le RLM, dans un vrai bac à sable. Sur les questions à un seul fait, il s’est comporté comme un agent qui écrit son propre grep : aussi précis, plus lent, et avec une exécution de code à sécuriser.
Et dans tous les cas : demandez la citation. Quelle que soit l’architecture, les dernières erreurs venaient du modèle qui mélangeait le document avec sa mémoire. Une réponse accompagnée de sa phrase source se vérifie ; une réponse seule, non.
Cinq leçons de deux semaines de tests
- L’architecture compte plus que son réglage. Sur 33 romans, le meilleur réglage du RAG (32 extraits) atteignait 71 %. Le réglage intermédiaire de la recherche hybride atteignait 83 %, et un agent avec seulement grep, 88 %. Régler fait avancer le long d’une courbe ; changer d’architecture déplace la courbe.
- Les mots exacts sont sous-estimés. Dans ce test, la recherche par le sens n’a jamais trouvé un passage que la recherche par mots-clés avait raté. Mes questions emploient les mots mêmes de Verne, ce qui favorise les mots-clés, mais les documents d’entreprise sont eux aussi pleins de mots exacts.
- Posez chaque question plusieurs fois. La même configuration a obtenu 76 % et 67 % sur deux campagnes identiques. Plusieurs types d’échec (un raisonnement qui ne s’arrête jamais, un modèle qui perd la question) ne sont apparus que dans quelques pour cent des passages. Un seul passage par question aurait présenté du bruit comme des résultats.
- Les données de test sont du code. Les questions, les modifications et les réponses attendues sont produites par des scripts, versionnées et vérifiées avant chaque campagne. Une modification erronée ou une réponse attendue trop stricte ressemble exactement à un échec du modèle. Quand un résultat vous surprend, vérifiez d’abord vos propres données.
- Ne supposez pas que la partie astucieuse a lieu. La fonctionnalité phare du RLM, le modèle qui s’appelle lui-même sur des morceaux du texte, n’a jamais tourné en 270 questions. Si votre conception dépend d’un comportement, mesurez-le.
Ce que ce test ne dit pas
- Un seul modèle. Chaque chiffre vient de Qwen3.8-27B sur une seule machine. Un autre modèle, surtout plus grand, pourrait changer l’ordre des agents et du RLM.
- Des questions dans les mots mêmes des livres. Cela favorise la recherche par mots-clés, grep et les regex du RLM. Des questions formulées comme parlent vraiment les utilisateurs favoriseraient davantage la recherche par le sens.
- Uniquement des faits isolés. Aucune question ne demandait de relier deux faits, de compter ou de résumer. Cela changerait le tableau, probablement en faveur des agents et du RLM.
- Des faits modifiés dans un texte célèbre. C’était le but : cela sépare la lecture de la mémoire. Mais cela fait aussi de la mémoire un piège plus fort que dans la plupart des documents d’entreprise.
- Pas de réglage par architecture. Même règle de consigne, mêmes budgets, des boucles simples. Un système en production réglerait chacune.
Ce que je testerais ensuite
- Un second modèle sur le même banc d’essai, pour voir quels résultats tiennent à l’architecture et lesquels à Qwen.
- Des questions formulées autrement que le texte, le vrai test pour la recherche par le sens.
- Les extraits voisins dans la recherche hybride : l’Atlantide était à un extrait près.
- Un RLM obligé de déléguer, avec des questions qui demandent de tout lire, pour tester la récursion que cette série n’a jamais vue.
- Des questions à plusieurs faits et d’agrégation, où je m’attends à ce que le classement change.
En bref
Sur une machine qui tient sur un bureau, avec des documents qui n’en sortent jamais, un modèle de 27 milliards de paramètres a trouvé des faits modifiés dans 33 romans environ 9 fois sur 10. Le choix de l’architecture a fait la différence entre 71 % et 91 %, et entre 9 secondes et 44.
Pour la plupart des entreprises, la réponse commence par la recherche hybride pour la vitesse, un agent avec grep quand la précision compte davantage, et des citations pour chaque réponse, quel que soit le choix.