Étude et démonstrateur
Recherche agentique : laisser le modèle chercher
L’aiguille dans la botte de foin, partie 5 sur 7. Pas d’index, quatre outils, et un modèle qui décide où regarder.
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup
- RAG : le bibliothécaire et son catalogue
- Recherche hybride : quand les mots exacts comptent
- Recherche agentique : laisser le modèle chercher ← vous êtes ici
- RLM : le modèle qui écrit sa propre recherche
- Le verdict : quelle architecture, pour quelle botte de foin
Là où la recherche hybride nous a laissés
La recherche hybride apportait le bon passage au modèle pour 15 de mes 16 faits modifiés, sur un roman comme sur 33. Il restait deux problèmes.
L’Atlantide (rebaptisée Thalassie dans mon texte) n’a jamais été trouvée : 0 sur 60. Le passage qui correspond à la question décrit le continent ; le nom se trouve quelques paragraphes plus haut, dans un autre extrait. La réponse était à un extrait près.
La prime figurait dans la consigne, classée entre le 2e et le 4e rang, et le modèle a quand même répondu NOT FOUND 16 fois sur 30 sur 7 et 33 romans.
Un lecteur humain réglerait les deux en regardant autour : lire la page précédente, chercher un autre mot. Dans cette partie, c’est donc au modèle de le faire.
Le fonctionnement ici
Pas de pipeline cette fois. Le modèle reçoit la question, quelques outils, et jusqu’à 25 appels d’outils. Il décide quoi chercher, quoi lire, et quand il tient la réponse.
En termes de bibliothèque : ni bibliothécaire ni catalogue. Le lecteur parcourt les rayons avec une fonction de recherche et ouvre les livres lui-même.
Les outils sont quatre simples fonctions sur le même texte que dans les autres parties :
| Outil | Ce qu’il fait |
|---|---|
list_works |
les romans de la bibliothèque, avec leur nombre de chapitres |
list_chapters(work) |
les titres de chapitre d’un roman |
grep(pattern) |
trouve un mot ou un motif partout, sans tenir compte des majuscules ni des accents ; renvoie un court extrait par paragraphe trouvé, avec le roman, le chapitre et le numéro de paragraphe |
read(work, chapter, start) |
lit jusqu’à 30 paragraphes consécutifs |
Le modèle n’exécute jamais de code ni de commande ; il ne peut qu’appeler ces quatre fonctions.
J’ai fait tourner deux versions :
- Agent, grep + lecture : les quatre outils ci-dessus. Aucun index, aucun modèle d’embeddings, rien de préparé à l’avance.
- Agent + recherche : la même chose, plus un cinquième outil,
search(query), qui est la recherche hybride de la partie 4 (sens + mots-clés + reranker). Chaque passage arrive avec son emplacement, pour que l’agent puisse lereadautour.
La boucle fait environ 150 lignes dans mon banc d’essai, pas un framework d’agents, pour que rien de caché ne change d’une partie à l’autre. Même modèle Qwen3.8-27B, même consigne (« réponds uniquement à partir du texte, ou dis NOT FOUND »), mêmes réglages de raisonnement, mêmes 16 faits, mêmes quatre tailles de corpus, même notation, 5 passages par question.
Une ligne est ajoutée à la consigne : la bibliothèque a pu être modifiée, ne te fie donc qu’à ce que renvoient les outils. C’est la version honnête d’un vrai déploiement : vous diriez la même chose à un agent à propos de vos propres documents.
Budgets : 25 appels d’outils et 60 000 tokens de consigne par question. Les dépasser compte comme NOT FOUND. En pratique, aucune limite n’a jamais été atteinte.
Résultats
| Précision | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Grand contexte | 100 % | 95 % | ❌ | ❌ |
| RAG, 32 extraits | 100 % | 85 % | 79 % | 71 % |
| Hybride, 16 extraits | 100 % | 94 % | 88 % | 83 % |
| Agent, grep + lecture | 97 % | 91 % | 90 % | 88 % |
| Agent + recherche | 100 % | 95 % | 84 % | 88 % |
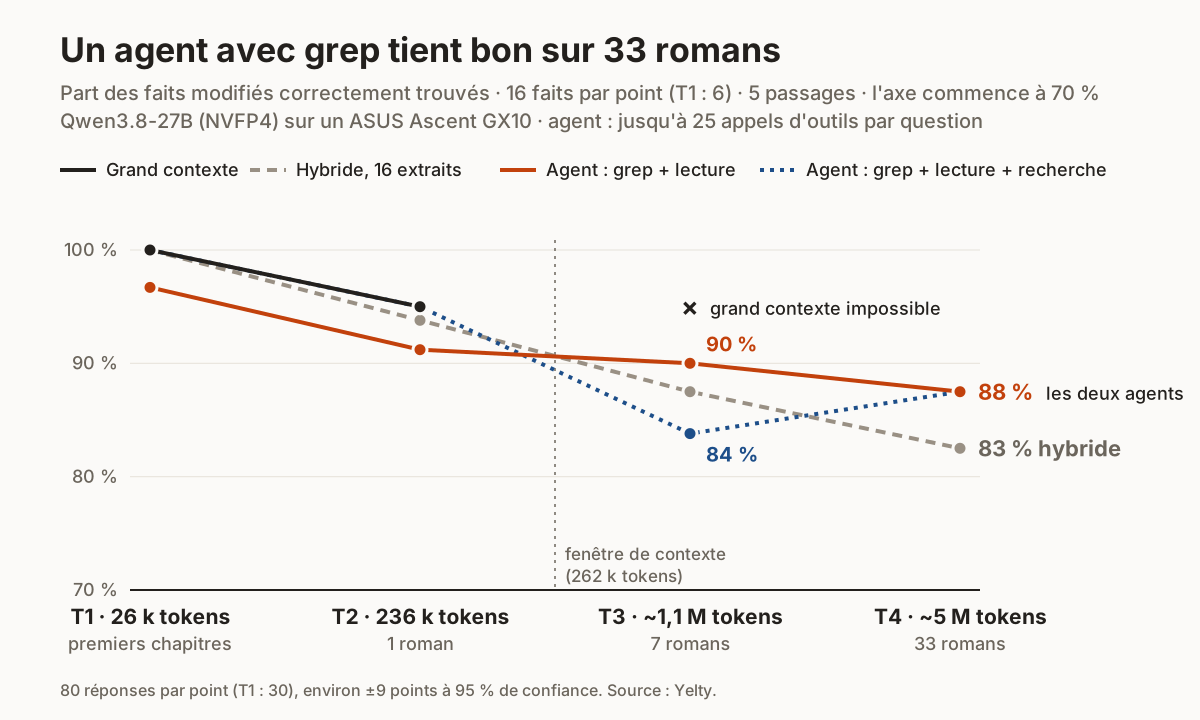 Les deux agents finissent à 88 % sur 33 romans. L’agent qui n’a que grep et la lecture est la courbe la plus stable d’un roman à 33.
Chaque chiffre des agents repose sur 80 réponses (T1 : 30), soit environ ±9 points. Les écarts entre les agents et la recherche hybride restent dans le bruit à toutes les tailles. C’est la tendance qui compte : l’agent perd moins à mesure que la bibliothèque grandit.
1. L’agent trouve le passage presque à chaque fois
Pour chaque question, j’ai relevé si le passage contenant la réponse apparaissait dans ce que renvoyaient les outils.
| Passage de la réponse vu par l’agent | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Agent, grep + lecture | 97 % | 96 % | 96 % | 94 % |
| Agent + recherche | 100 % | 100 % | 99 % | 99 % |
Et vite. Avec grep et la lecture, la question médiane a demandé 2 à 3 appels d’outils. Avec la recherche, 1 : sur 1, 7 et 33 romans, 61 % des questions ont reçu leur réponse après un seul appel. La recherche la plus longue a demandé 22 appels, sur 33 romans, toujours sous le budget de 25.
La date du pôle montre pourquoi grep marche si bien sur ce type de question. Avec grep et la lecture, l’agent a répondu « 25 mars » correctement 15 fois sur 15 sur 1, 7 et 33 romans, et 11 fois avec un seul grep : le passage (« je prends possession de cette partie du globe ») est revenu dès la première recherche. C’est ce que faisait la recherche par mots-clés dans la partie 4, sauf que c’est le modèle qui choisit le mot-clé.
2. La prime : résolue en regardant autour
Sur 7 et 33 romans, la recherche hybride donnait au modèle le passage de la prime, et le modèle répondait NOT FOUND plus d’une fois sur deux.
Chaque agent y a répondu correctement 10 fois sur 10 sur 7 et 33 romans. Avec grep et la lecture, il a fallu entre 4 et 13 appels d’outils, et de 25 secondes à 3 minutes. Les traces montrent le même schéma à chaque fois : grep « prime », des résultats dans plusieurs romans, grep « monstre » ou « signalera », puis lecture du bon chapitre de Vingt mille lieues sous les mers, et souvent un dernier grep sur « quatre mille cinq cents » pour confirmer avant de répondre.
Pourquoi l’agent est plus sûr de lui que la recherche hybride avec le même passage, ce test ne permet pas de le prouver. Une différence est visible : chaque résultat de grep arrive avec son roman et son chapitre, l’agent peut donc distinguer la prime de Vingt mille lieues sous les mers des autres primes des autres romans, et il vérifie avant de répondre. Avec la recherche hybride, ces passages arrivaient ensemble, comme des extraits sans beaucoup de contexte.
3. L’Atlantide : le problème de recherche est devenu un problème de mémoire
L’Atlantide était le fait qu’aucune recherche ne trouvait. L’agent l’a trouvée à chaque fois : le nom Thalassie est apparu dans un résultat d’outil dans 15 passages sur 15, sur 1, 7 et 33 romans, pour les deux agents. Il a fallu une médiane de 7 appels d’outils avec grep et la lecture, 4 avec la recherche.
La façon dont il a cherché est parlante. Dans 25 des 30 passages, l’agent a lancé à un moment un grep sur « Atlantide » ou « Atlantis », et dans 14 cas c’était sa toute première recherche. Le modèle cherchait le nom dont il se souvenait. Ce nom n’est pas dans mon roman modifié, grep n’y trouvait donc rien, et l’agent passait à des mots comme « continent » et « disparu », puis lisait le chapitre « Un continent disparu » jusqu’à trouver Thalassie. La mémoire orientait la recherche dans la mauvaise direction ; les outils l’ont corrigée.
Et pourtant, la réponse a surtout été notée fausse : 5 justes sur 15 avec grep et la lecture, 3 sur 15 avec la recherche.
Les réponses ressemblent à ceci :
La Thalassie (l’Atlantide de Platon).
La Thalassie (le continent submergé d’Atlantide).
L’agent a lu le bon passage, donné le bon nom, puis ajouté celui dont il se souvient. Le passage dit « la Thalassie de Platon », et le modèle complète avec ce qu’il a appris à l’entraînement. 10 des 15 réponses avec grep et la lecture, et 12 sur 15 avec la recherche, citaient les deux.
La mémoire ne venait pas du texte. « Atlantide » n’apparaît jamais dans mon Vingt mille lieues sous les mers modifié, et dans seulement 2 des 30 passages un outil l’a renvoyé : un passage d’un autre roman de la bibliothèque de 33 romans (« les Atlantides » de Platon, dans la théorie d’un astronome).
Ma notation compte une réponse à deux noms comme fausse, comme dans chaque partie. Pour un lecteur, « La Thalassie (l’Atlantide de Platon) » est sans doute une bonne réponse. Pour un système qui doit rapporter uniquement ce que disent les documents, non : la seconde moitié vient de la mémoire, et rien dans la réponse ne dit laquelle.
C’est le résultat le plus intéressant de cette partie. La recherche hybride cachait ce comportement, parce qu’elle n’amenait jamais le modèle jusque-là. Plus la recherche est bonne, plus on voit ce que le modèle fait du passage.
4. La recherche ramène les sosies
Sur le Maelström (rebaptisé Corryvreckan), les deux agents se séparent :
| Maelström → Corryvreckan, justes | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Agent, grep + lecture | — | 3/5 | 3/5 | 5/5 |
| Agent + recherche | — | 4/5 | 0/5 | 0/5 |
(— : le Maelström arrive à la fin du roman, il n’est donc pas dans les premiers chapitres et n’est pas demandé en T1.)
Avec la recherche, sur 7 et 33 romans, la réponse était presque toujours « Le Corryvreckan (le Maelström) », et deux fois simplement « le Maëlstrom ». La recherche hybride renvoie les meilleurs passages de tous les romans, et plusieurs autres romans de Verne emploient « maelström » pour n’importe quel tourbillon. Le modèle voit les deux mots et hésite, comme dans la partie 4.
Avec grep, chaque résultat indique de quel roman il vient, l’agent peut donc rester dans Vingt mille lieues sous les mers. Sur 33 romans, il a trouvé le Maelström 5 fois sur 5. (Sur un roman, il a répondu deux fois par le surnom du tourbillon dans le passage, « le Nombril de l’Océan », au lieu du nom.)
Le cinquième outil a donc rendu l’agent plus rapide et plus régulier sur un roman, et moins bon sur 7 romans (84 % contre 90 %). C’est le compromis de toute recherche : ce qu’elle ramène qui a l’air pertinent, le modèle doit le trier.
5. Ce qui a mal tourné, une fois le passage trouvé
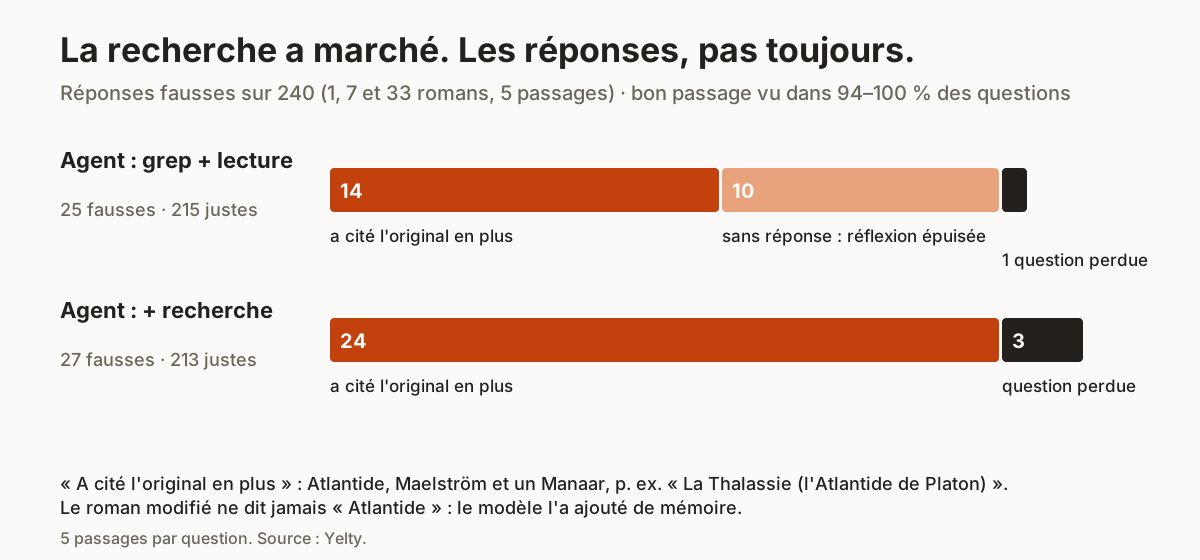
Sur 1, 7 et 33 romans réunis, chaque agent a donné environ 25 réponses fausses sur 240 (10–11 %).
- A cité l’original en plus (14 et 24). L’Atlantide (10 et 12) et le Maelström (4 et 11), comme plus haut, plus un cas sur la pêcherie de perles : « golfe de Kalpitiya (golfe de Manaar) ». Avec la recherche, deux réponses sur le Maelström donnaient le nom d’origine seul.
- Pas de réponse : réflexion épuisée (10, grep + lecture uniquement). À chaque fois juste après le premier appel d’outil, le modèle a raisonné jusqu’à épuiser toute sa sortie autorisée (4 096 tokens, la même dans chaque partie) sans jamais répondre. Chaque cas a pris environ 2 min 40 s. Cela ne s’est jamais produit quand l’outil de recherche était disponible. Je ne sais pas pourquoi ; c’est le genre d’échec qu’on ne voit qu’en posant chaque question plusieurs fois.
- A perdu la question (1 et 3). Après un long résultat d’outil, le modèle a répondu comme si l’utilisateur avait collé un texte : « Vous avez collé un long ensemble d’extraits de romans de Jules Verne… », ou, une fois, en anglais, « I don’t have any previous thinking to translate ». La question était toujours là ; le modèle ne savait plus à qui c’était le tour. Le cas avec grep et lecture était différent : le modèle a écrit sa recherche suivante en texte simple (« I need to search for the specific content. ») au lieu d’appeler l’outil, et la boucle l’a prise pour la réponse.
À part ces deux réponses « Maëlstrom », aucune réponse n’a donné une franche valeur fausse : ni mauvaise année, ni mauvais nom seul. Dans la partie 3, le RAG répondait « 1859 » ou « 1866 » pour la date. Ici, chaque erreur était une hésitation, une absence de réponse ou une confusion.
Coût et vitesse
| Recherche hybride | Agent, grep + lecture | Agent + recherche | |
|---|---|---|---|
| Préparation | embeddings + mots-clés : 30 s à 3 min 39 s | aucune | comme l’hybride |
| Modèle supplémentaire en service | modèle d’embeddings + reranker | aucun | modèle d’embeddings + reranker |
| Appels d’outils par question (médiane ; 10 % les plus lents) | — | 2–3 ; 5–10 | 1 ; 2–4 |
| Temps de réponse médian | 8–11 s | 16–26 s | 11–12 s |
| 10 % des réponses les plus lentes | — | 42 s à 2 min 35 s | 27–40 s |
| Texte dans la consigne | 4 000–15 000 tokens | jusqu’à 33 000 tokens | jusqu’à 23 000 tokens |
| Tokens lus par question, 33 romans (médiane, tous appels) | 7 700 | 10 600 | 5 600 |
| Tokens écrits par question, 33 romans (médiane ; 10 % les plus lents) | 180 ; 780 | 480 ; 3 500 | 190 ; 720 |
| Précision, 1 / 33 romans | 94 % / 83 % | 91 % / 88 % | 95 % / 88 % |
L’agent avec grep et la lecture n’a besoin de rien préparer ni de rien faire tourner en plus. Sur 33 romans, c’est le système le moins cher à mettre en place et le plus lent à répondre : la médiane est de 26 secondes, et une question sur dix prend plus de deux minutes et demie, surtout les passages où la réflexion s’est épuisée.
Les tokens racontent la même histoire. Une réponse typique de l’agent écrit environ 480 tokens, raisonnement compris, sur l’ensemble de ses appels : 2,5 fois la recherche hybride. Les 10 % les plus lents en écrivent 3 500 ou plus, ce sont les passages où le raisonnement a épuisé toute la sortie autorisée. Avec l’outil de recherche, l’agent lit et écrit à peu près aussi peu que la recherche hybride seule.
Ajouter la recherche divise par deux le temps et le nombre d’appels, et garde la précision sur 33 romans. Cela coûte tout l’index hybride.
Ce que je dirais à un client
Quand un agent vaut le coup
- Quand le corpus change souvent, ou qu’on ne peut pas l’indexer. Grep ne demande aucune préparation : un nouveau document est interrogeable dès qu’il est sur le disque.
- Quand la question demande de regarder autour : un fait réparti sur deux paragraphes, un nom défini une page plus tôt, plusieurs candidats à comparer. C’est là que l’agent a réglé ce que la recherche hybride ne pouvait pas.
- Quand on peut attendre de 20 secondes à 2 minutes par question. Un agent est un assistant de recherche, pas une barre de recherche.
Ce qu’il faut surveiller
- Une meilleure recherche met le modèle à nu. Une fois que l’agent trouve le passage, ce qui reste, c’est le modèle qui mélange les documents avec ce dont il se souvient. Demandez des citations, ou vérifiez les réponses par rapport au passage, si cela compte.
- Donnez un périmètre à l’agent. Un outil de recherche global ramène des sosies de tous les documents. Un grep qui indique l’emplacement permet à l’agent de rester dans le bon.
- Posez chaque question plusieurs fois. Deux des types d’échec vus ici (une réflexion qui ne s’arrête jamais, un modèle qui perd la question) ne sont apparus que dans quelques pour cent des passages. Un seul passage par question les aurait ratés.
Limites de ce test
- Des questions dans le vocabulaire du roman. Comme dans la partie 4, mes questions emploient les mots de Verne, ce qui favorise grep. Une question formulée autrement que le texte obligerait l’agent à deviner d’autres mots, ou à utiliser l’outil de recherche.
- Un seul modèle. Qwen3.8-27B avec son propre format d’appel d’outils, servi par vLLM. La qualité des appels d’outils varie beaucoup d’un modèle à l’autre ; un autre modèle pourrait tourner en rond, abandonner plus tôt, ou mieux suivre la consigne.
- Une boucle simple. Pas d’étape de planification, pas d’auto-vérification, pas de mémoire entre les questions. Les frameworks d’agents les ajoutent ; je les ai laissées de côté pour que la comparaison reste équitable.
- Cinq réponses par point. Environ ±9 points. Les agents et la recherche hybride restent dans le bruit les uns des autres à toutes les tailles.
- « Vu » signifie que la réponse modifiée est apparue dans un résultat d’outil, pas que le modèle l’a lue attentivement.
- Uniquement des faits contrefactuels, comme dans les parties précédentes.
La suite : RLM
L’agent appelait les outils un par un, et le résultat de chaque appel revenait dans sa consigne. Sur 33 romans, cela a marché, parce que grep renvoie de courts extraits.
Les Recursive Language Models vont un cran plus loin : le modèle écrit du code pour explorer le texte, et peut s’appeler lui-même sur des morceaux. C’est la dernière architecture de cette série, et celle qui a le plus de chances de casser sur un modèle local. → Partie 6 : RLM