Étude et démonstrateur
RLM : le modèle qui écrit sa propre recherche
L’aiguille dans la botte de foin, partie 6 sur 7. La bibliothèque est une variable ; le modèle écrit du Python, et il ne s’appelle jamais lui-même.
La série
- Une aiguille chez Jules Verne
- Grand contexte : tout lire d’un coup
- RAG : le bibliothécaire et son catalogue
- Recherche hybride : quand les mots exacts comptent
- Recherche agentique : laisser le modèle chercher
- RLM : le modèle qui écrit sa propre recherche ← vous êtes ici
- Le verdict : quelle architecture, pour quelle botte de foin
Là où l’agent nous a laissés
Dans la partie 5, un agent doté de quatre outils (lister les romans, lister les chapitres, grep, lire) trouvait le passage modifié dans 94 % des questions ou plus, et répondait juste à 88 % sur 33 romans. Ce qu’il ne pouvait pas faire, c’est tout ce pour quoi je n’avais pas écrit d’outil.
Les Recursive Language Models (Zhang et Khattab, 2025) suppriment la liste d’outils. Le modèle reçoit un interpréteur Python, toute la bibliothèque dans une seule variable, et une fonction de plus : il peut confier un morceau de texte à une autre copie de lui-même. La recherche dont il a besoin, il l’écrit.
En termes de bibliothèque : ni catalogue, ni bibliothécaire, ni rayons. Le lecteur reçoit toute la bibliothèque sous la forme d’un très long rouleau, un langage de programmation, et des assistants qu’il peut envoyer en lire des parties.
Le fonctionnement ici
Le modèle ne voit jamais le texte dans sa consigne. Il voit la question et une ligne : « context contient 18 111 017 caractères ». Puis il écrit du code.
import re
pat = re.compile(r'p[ôo]le\s+[-–—]?\s*sud', re.I)
ms = list(pat.finditer(context))
print("matches", len(ms))
for m in ms[:5]:
    print(m.start(), context[m.start()-400:m.end()+400])
Le code s’exécute, le modèle lit ce qu’il a affiché, et écrit le bloc suivant. Quand il tient la réponse, il écrit FINAL(...).
Ce que le modèle peut appeler dans son code
| Fonction | Ce qu’elle fait |
|---|---|
context |
tout le palier en une seule chaîne : de 97 000 caractères (T1) à 18,1 millions (T4) |
llm_query(prompt) |
envoie une consigne à un autre appel du même modèle, qui ne voit que cette consigne (jusqu’à ~98 000 caractères), et renvoie sa réponse |
llm_query_batched(prompts) |
la même chose pour une liste, 8 à la fois |
FINAL(answer) / FINAL_VAR(name) |
termine la question |
Les sous-appels sont la partie « récursive ». Ce sont de simples appels au modèle, sans l’interpréteur, ils ne peuvent donc pas appeler eux-mêmes d’autres copies (profondeur de récursion 1, comme dans les principales expériences de l’article).
Mêmes règles que dans chaque partie : même modèle Qwen3.8-27B, même consigne (« réponds uniquement à partir du texte, ou dis NOT FOUND »), mêmes réglages de raisonnement et même sortie autorisée de 4 096 tokens par appel, mêmes 16 faits modifiés, mêmes quatre tailles de corpus, même notation, 5 passages par question. Comme dans la partie 5, une ligne est ajoutée : la bibliothèque a pu être modifiée, ne te fie qu’au texte de context.
Budgets par question : 20 tours, 60 sous-appels, environ 32 000 tokens par sous-appel, 12 000 caractères de sortie affichée par tour (le même plafond que pour les résultats d’outils de la partie 5), et 30 secondes de calcul par bloc de code. Épuiser les tours compte comme NOT FOUND.
La boucle fait environ 300 lignes dans mon banc d’essai. Je n’ai pas utilisé le package des auteurs : je voulais chaque bloc de code journalisé, la même notation que dans les autres parties, et l’interpréteur dans un conteneur séparé. Une règle reprend la partie 5 : un tour qui exécute du code ne répond pas. Si le modèle écrit FINAL(...) à côté d’un bloc de code, avant d’en avoir vu le résultat, la réponse est mise de côté et le modèle voit d’abord le résultat. (C’est arrivé lors d’un essai pilote ; dans la campagne complète, jamais.)
Un modèle qui exécute son propre code a besoin d’une cage
Le modèle écrit du Python arbitraire, il tourne donc dans un conteneur sans aucun réseau. Pas un réseau restreint : aucun. Il communique avec le banc d’essai par deux sockets locales, l’une pour recevoir le code, l’autre pour envoyer les sous-appels. Le banc transmet les sous-appels au modèle et les compte.
Avant la campagne, un contrôle tente de s’échapper. Les dix vérifications sont passées :
| Vérification | Résultat |
|---|---|
| Atteindre internet | bloqué |
| Atteindre directement le serveur du modèle | bloqué |
| Écrire dans le système ou dans le corpus | bloqué (lecture seule) |
| Tourner en root | non : utilisateur sans privilèges |
| Boucle infinie | arrêtée au bout de 30 s, l’interpréteur reste utilisable |
| Sous-appels via le banc d’essai | fonctionnels |
C’est la partie du RLM que personne ne met sur une slide. La recherche agentique de la partie 5 appelait quatre fonctions que j’avais écrites. Le RLM exécute tout ce que le modèle écrit. Sur vos propres données, c’est un projet de sécurité avant d’être un projet d’IA.
Résultats
| Précision | T1 | T2 | T3 | T4 |
|---|---|---|---|---|
| Grand contexte | 100 % | 95 % | ❌ | ❌ |
| RAG, 32 extraits | 100 % | 85 % | 79 % | 71 % |
| Hybride, 16 extraits | 100 % | 94 % | 88 % | 83 % |
| Agent, grep + lecture | 97 % | 91 % | 90 % | 88 % |
| Agent + recherche | 100 % | 95 % | 84 % | 88 % |
| RLM | 100 % | 94 % | 89 % | 91 % |
Chaque chiffre du RLM repose sur 80 réponses (T1 : 30), soit environ ±9 points. Le RLM, les deux agents et la recherche hybride restent dans le bruit les uns des autres sur 1 et 7 romans. Sur 33 romans, le RLM et les deux agents devancent la recherche hybride et distancent largement le RAG.
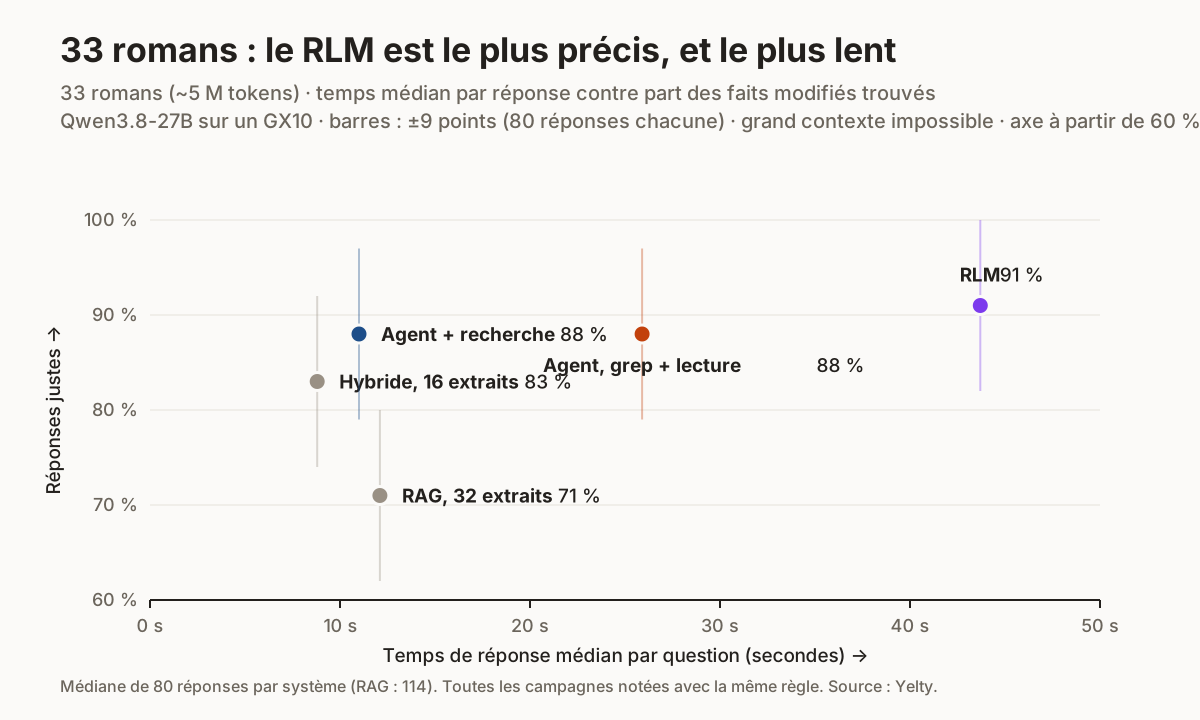 Sur 33 romans, le RLM donne le plus de bonnes réponses et prend le plus de temps. L’agent avec recherche est le meilleur compromis côté vitesse.
1. Le modèle ne s’est jamais appelé lui-même
Sur 270 questions, le modèle a fait zéro sous-appel. Ni sur un roman, ni sur 33.
Il n’en avait pas besoin. Chaque question a été résolue avec des expressions régulières, des tranches de context et des print : une médiane de 3 tours sur les premiers chapitres et sur un roman, 4 sur 7 et 33 romans, avec 2 à 3,5 blocs de code par question. Presque aucune erreur de code, et aucun bloc n’a jamais atteint la limite de 30 secondes.
Le contrôle d’avant campagne a prouvé que les sous-appels fonctionnaient. Le modèle a simplement choisi de ne pas s’en servir, pour des raisons que je peux en partie expliquer :
- Ces questions ont la forme d’un grep. Chaque fait modifié est un nom ou une date courte près de mots distinctifs (« prime », « pôle », « gouffre »). Une expression régulière trouve le passage en quelques tours, presque gratuitement. Un sous-appel coûte un appel complet au modèle sur jusqu’à 32 000 tokens et ne trouve rien qu’une regex raterait. L’article sur les RLM constate la même chose sur les tâches à une seule aiguille : les modèles filtrent avec du code, et les sous-appels deviennent rentables sur les tâches qui demandent du sens sur la plus grande partie du texte, comme compter ou agréger.
- Mes instructions orientent vers le code d’abord. Les conseils de la consigne disent : regarde la structure, cherche des mots-clés avec
re, et utilise les sous-appels « si les mots-clés ne suffisent pas ». Ils ont toujours suffi. - Sur 33 romans, tout lire n’est pas possible. 18,1 millions de caractères en morceaux de 98 000, c’est environ 185 sous-appels. Le budget est de 60. Sur un roman, 9 auraient tout couvert ; le modèle n’a pas essayé.
- Le modèle est un codeur. Écrire une regex, c’est ce pour quoi il a été entraîné.
llm_queryest une fonction qu’il n’a jamais vue.
Donc, tel qu’utilisé ici, le RLM est un agent qui écrit son propre grep. C’est le résultat honnête de cette partie, et sa principale limite.
2. Il navigue par numéros
Le code montre comment le modèle se représente le texte : comme des positions. Une recherche typique lors d’un essai pilote sur 33 romans :
- Chercher
pôle sudpartout : 31 correspondances, en afficher cinq avec leur position. - Remarquer que les correspondances de Vingt mille lieues sous les mers se situent autour du caractère 2 050 000.
- Découper
context[2050000:2300000]et y chercher des dates. - Resserrer sur
context[2094000:2110000]: « Sommes-nous au pôle ? … A midi nous ferons le point. »
Ni chapitres, ni titres : des positions, comme faire défiler un document avec sa barre de défilement. L’agent de la partie 5 demandait le chapitre 14 d’un roman nommé ; le RLM demande les caractères 2 094 000 à 2 110 000.
Son tout premier réflexe, lors du contrôle d’avant campagne, a été print(repr(context)) : afficher toute la bibliothèque. La sortie étant plafonnée à 12 000 caractères par tour, il a obtenu les premières pages et a dû changer d’approche. Un plafond qui ressemble à un détail technique est ce qui permet à la méthode de fonctionner tout court.
3. Il trouve le passage, et le croit la plupart du temps
| T1 | T2 | T3 | T4 | |
|---|---|---|---|---|
| Passage de la réponse affiché par le code du modèle | 100 % | 98 % | 90 % | 95 % |
| Justes quand le passage a été affiché | 100 % | 96 % | 99 % | 96 % |
Le passage modifié est parvenu au modèle dans 90 à 100 % des questions. Quand c’était le cas, la réponse était juste de 96 à 100 % du temps. Sur les premiers chapitres, les deux étaient à 30 sur 30.
Trois faits racontent l’histoire par rapport aux parties précédentes :
| Justes, sur 1, 7 et 33 romans | Hybride, 16 | Agent, grep + lecture | Agent + recherche | RLM |
|---|---|---|---|---|
| La prime | — | 10/10 (7 et 33 romans) | 10/10 (7 et 33 romans) | 15/15 |
| Atlantide → Thalassie | 0/15 | 5/15 | 3/15 | 9/15 |
| Maelström → Corryvreckan | — | 11/15 | 4/15 | 11/15 |
L’Atlantide est la surprise. Aucune recherche ne l’avait trouvée dans la partie 4 ; les agents la trouvaient à chaque fois puis ajoutaient le plus souvent « l’Atlantide » de mémoire. Le RLM a répondu simplement « Thalassie » 9 fois sur 15. Il a quand même hésité 5 fois (« La Thalassie, l’ancienne Atlantide de Platon »). Pourquoi il hésite moins, ce test ne permet pas de le prouver. Une différence est visible : les agents lisaient des extraits et des paragraphes choisis par les outils ; le RLM affichait des tranches qu’il choisissait lui-même, souvent longues.
Certaines réponses ressemblent à des hésitations sans en être : « La Thalassie, l’ancienne Méropide de Théopompe » figure dans le texte même de Verne, et a été notée juste.
4. Ce qui a mal tourné
Sur 1, 7 et 33 romans réunis, le RLM a donné 21 réponses fausses sur 240 (9 %). Trois catégories :
- L’a trouvé, puis y a mêlé sa mémoire (7). L’Atlantide avec les deux noms (5), et deux fois sur 33 romans le Maelström : le modèle a affiché le passage modifié et a quand même répondu « le Maëlström ».
- N’a jamais cherché (6, toutes sur 7 et 33 romans). Le modèle a répondu dès son premier tour sans écrire de code. Trois fois avec un nom : « Farragut » et « l’Abraham Lincoln », les noms de l’histoire originale, et « l’île aux Coraux », qui n’est dans aucune des deux versions. Trois fois, son raisonnement a épuisé toute la sortie autorisée avant d’écrire une seule ligne. Ces cas ont pris de 35 secondes à plus de 3 minutes. Le premier message lui demandait pourtant d’explorer
contextavant de répondre. - A cherché, sans atteindre le passage (8). La date du pôle, trois fois, avec la réponse « 19 mars ». Le Maelström deux fois et l’Atlantide une fois, de mémoire. Une question a épuisé ses tours (20), une autre ses tokens de sortie en pleine recherche.
Les erreurs « n’a jamais cherché » sont nouvelles. L’agent de la partie 5 appelait toujours un outil d’abord. Ici, avec un interpréteur au lieu d’outils, le modèle saute parfois le travail et répond avec ce qu’il sait. Sur les premiers chapitres et sur un roman, cela ne s’est jamais produit ; sur 7 et 33 romans, 6 fois sur 160.
« 19 mars » n’est pas de la mémoire : c’est dans le texte. Quelques paragraphes avant le pôle, Verne écrit « ce jour mémorable du 19 mars », le matin où le Nautilus fait surface près du pôle. Le modèle a trouvé le bon chapitre, lu une date qui ressemblait à la réponse, et s’est arrêté avant la phrase contenant la date modifiée. C’est la seule franche valeur fausse donnée par le RLM, et elle venait des documents, pas de l’entraînement.
La date du pôle est l’inverse de la partie 5 : l’agent avec grep l’a eue 15 fois sur 15, souvent en une seule recherche. Le RLM l’a eue 12 fois. Dans la trace pilote que j’ai lue, son propre code l’a gêné : il cherchait les noms de mois sans tenir compte de la casse, si bien que « mai » correspondait à chaque « Mais » et « maître », et le bruit remplissait la sortie avant d’arriver à mars. Écrire sa propre recherche, c’est écrire ses propres bugs.
Coût et vitesse
| Recherche hybride | Agent, grep + lecture | Agent + recherche | RLM | |
|---|---|---|---|---|
| Préparation | embeddings + mots-clés : 30 s à 3 min 39 s | aucune | comme l’hybride | aucune |
| En service en plus | modèle d’embeddings + reranker | rien | modèle d’embeddings + reranker | un conteneur bac à sable (CPU, 4 Go) |
| Étapes par question (médiane) | — | 2–3 appels d’outils | 1 appel d’outil | 3–4 tours |
| Temps de réponse médian, toutes tailles | 8–11 s | 16–26 s | 11–12 s | 19–44 s |
| Temps de réponse médian, 33 romans | 9 s | 26 s | 11 s | 44 s |
| 10 % les plus lents, 33 romans | 35 s | 2 min 35 s | 40 s | 1 min 36 s |
| Tokens lus par question, 33 romans (médiane, tous appels) | 7 700 | 10 600 | 5 600 | 11 000 |
| Tokens écrits par question, 33 romans (médiane ; 10 % les plus lents) | 180 ; 780 | 480 ; 3 500 | 190 ; 720 | 840 ; 2 000 |
| Précision, 1 / 33 romans | 94 % / 83 % | 91 % / 88 % | 95 % / 88 % | 94 % / 91 % |
Le RLM n’a besoin de rien préparer, comme l’agent avec grep, et coûte le plus de temps par réponse : une médiane de 44 secondes sur 33 romans, contre 26 pour l’agent avec grep et 11 avec la recherche. Ses réponses les plus lentes sont toutefois plus courtes que celles de l’agent : la longue traîne de l’agent venait d’un raisonnement qui ne s’arrêtait jamais.
C’est aussi lui qui écrit le plus : environ 840 tokens par réponse sur 33 romans, contre 480 pour l’agent et 180 pour la recherche hybride. Écrire du code, puis raisonner sur son résultat, coûte des tokens à chaque tour, et c’est là que passe le temps. Son nombre de tokens augmente avec la bibliothèque : environ 380 sur les premiers chapitres, 540 sur un roman, 720 sur 7 romans.
C’est aussi la seule option ici qui demande une conception de sécurité.
Ce que je dirais à un client
Quand le RLM vaut le coup
- Quand les questions demandent du code, pas seulement de la recherche : compter, comparer, extraire depuis des milliers d’endroits. C’est pour cela que la méthode a été conçue, et ce test ne le mesure pas.
- Quand on ne peut pas prévoir les outils. Un agent ne fait que ce que ses outils permettent ; le RLM écrit ce dont il a besoin.
- Pas pour trouver un fait. Sur ces questions, il s’est comporté comme un agent qui écrit son propre grep : aussi précis, plus lent, et avec un bac à sable à maintenir.
Ce qu’il faut surveiller
- Il exécute du code écrit par le modèle. Pas de réseau, lecture seule, sans privilèges, avec des limites de temps et de mémoire, et testez la cage avant chaque campagne.
- Plafonnez la sortie. Le premier réflexe du modèle a été de tout afficher.
- Vérifiez qu’il a cherché. Certaines réponses venaient de la mémoire au premier tour, sans une ligne de code. Journalisez le code, et rejetez une réponse qui n’a aucune recherche derrière elle.
- Ne supposez pas que la récursion a lieu. Sur 270 questions, le modèle n’a jamais délégué. Si votre cas d’usage dépend des sous-appels, mesurez-les.
Limites de ce test
- Les sous-appels n’ont jamais tourné, cette partie mesure donc l’écriture de code du RLM, pas sa récursion. Une consigne sans mes conseils « regex d’abord », ou des questions qui demandent de tout lire, testeraient l’autre moitié.
- Ma consigne et ma boucle. Les conseils que j’ai donnés façonnent le comportement, comme le ferait n’importe quelle consigne système. J’ai écrit ma propre boucle plutôt que d’utiliser le package des auteurs, les résultats avec leur consigne peuvent donc différer.
- Un seul modèle, Qwen3.8-27B sur une seule machine de bureau, avec une sortie autorisée de 4 096 tokens par tour. Un modèle plus grand écrirait peut-être un meilleur code, et déléguerait peut-être.
- Des questions dans le vocabulaire de Verne, ce qui favorise la recherche par mots-clés, comme dans les parties 4 et 5.
- Environ ±9 points par chiffre. Le RLM, les agents et la recherche hybride restent dans le bruit les uns des autres sur 1 et 7 romans.
- « Affiché » signifie que la réponse modifiée est apparue dans la sortie lue par le modèle, pas qu’il l’a lue attentivement.
La suite : le verdict
Six architectures, un modèle, une machine, les mêmes 16 faits modifiés. La partie 7 les met côte à côte : laquelle utiliser, pour quelle botte de foin, et ce que chacune coûte à faire tourner. → Partie 7 : le verdict